dowse : une alternative locale à Sourcegraph et GitHub Code Search
dowse permet d’effectuer des recherches de code sur de multiples dépôts Git simultanément, depuis une application de bureau ou directement en ligne de commande. Il apporte aux clones présents sur votre propre disque dur ce que GitHub code search et grep.app offrent sur GitHub : une barre de recherche unique, l’ensemble de vos dépôts et des résultats en quelques millisecondes. dowse reprend fidèlement la syntaxe de requête de GitHub code search, s’appuie sur tgrep (le moteur grep indexé par trigrammes publié en open source par Microsoft), gère un index dédié par dépôt à la façon de Zoekt, et ne nécessite aucun serveur en tâche de fond.
dowse fonctionne sous Windows, macOS et Linux. Il est gratuit et distribué sous licence MIT.
Télécharger la dernière version
Le code que vous cherchez se trouve rarement dans un seul dépôt
Quand vous souhaitez comprendre comment une fonction est appelée, où une clé de configuration est lue ou quels services dépendent encore d’une ancienne version d’une bibliothèque, la réponse est presque toujours dispersée sur des dizaines de dépôts : vos copies de travail au quotidien, les miroirs locaux des services de votre équipe et les dépendances externes de votre projet. Les outils existants ne couvrent chacun qu’une partie de ces besoins :
- GitHub code search est rapide et bénéficie d’une excellente syntaxe, mais il ne fouille que le code hébergé sur GitHub, se cantonne à la branche par défaut de chaque dépôt et limite ses résultats à 100 entrées par requête. La branche sur laquelle vous êtes en train d’écrire, vos modifications locales non encore poussées et les dépôts stockés sur d’autres forges en sont totalement absents.
- grep.app ne parcourt que les dépôts publics de GitHub. Le code propriétaire de votre entreprise n’y figure pas, et ne doit surtout pas s’y trouver.
- Sourcegraph est la plateforme de recherche de code la plus complète, proposant navigation sémantique et modifications en masse (batch changes). C’est aussi une architecture serveur lourde : il faut la déployer, la relier aux hébergeurs de code et l’administrer au quotidien. Pour une grande direction technique, c’est un investissement rentable ; pour un développeur individuel sur son poste de travail, c’est une débauche d’infrastructure juste pour explorer quelques dossiers.
- Zoekt, le moteur à base de trigrammes qui propulse Sourcegraph, est open source et extrêmement véloce. Mais il s’agit là encore d’un ensemble d’indexeurs et de serveurs qu’il faut configurer, exécuter et alimenter.
- Entrian Source Search dote Visual Studio d’un index plein texte, mais reste enfermé dans l’EDI et impose une licence payante par développeur.
- ripgrep et
git grepne requièrent aucune installation préalable, mais ils relisent l’intégralité des fichiers à chaque recherche, un seul arbre de répertoires à la fois. Dès que l’on passe à cinquante dépôts, l’instantanéité s’évanouit.
Je voulais disposer sur ma propre machine de l’efficacité de GitHub code search sur github.com : pouvoir interroger d’un coup mes miroirs synchronisés sur main, mes copies de travail en cours de développement, ainsi que mes modifications non commitées. C’est exactement ce que propose dowse.
Ce que fait dowse
La syntaxe de GitHub code search sur vos propres clones
Les requêtes sont interprétées au fur et à mesure de votre frappe, selon la syntaxe de GitHub code search. Les termes sont combinés au niveau du fichier et non d’une ligne isolée : ainsi, taper parse config trouve les fichiers contenant ces deux mots n’importe où dans leur contenu, puis surligne les lignes où apparaît au moins l’un d’eux.
parse config fichiers contenant les deux motsparse OR config fichiers contenant l'un ou l'autreparse NOT test contient parse, mais exclut test"fn main()" recherche exacte de l'expression/fn \w+_test/ ligne correspondant à l'expression régulièrepath:src/*.rs language:rust filtre par chemin glob et par langagerepo:api branch:main dépôts et branches ciblés-path:tests -lang:md critères d'exclusionUne requête composée exclusivement de filtres (comme path:*.proto) renvoie la liste des fichiers sans avoir à lire leur contenu. La sensibilité à la casse, la correspondance de mots entiers et les expressions régulières s’activent et se désactivent instantanément via des raccourcis clavier (Alt+C, Alt+W, Alt+R).
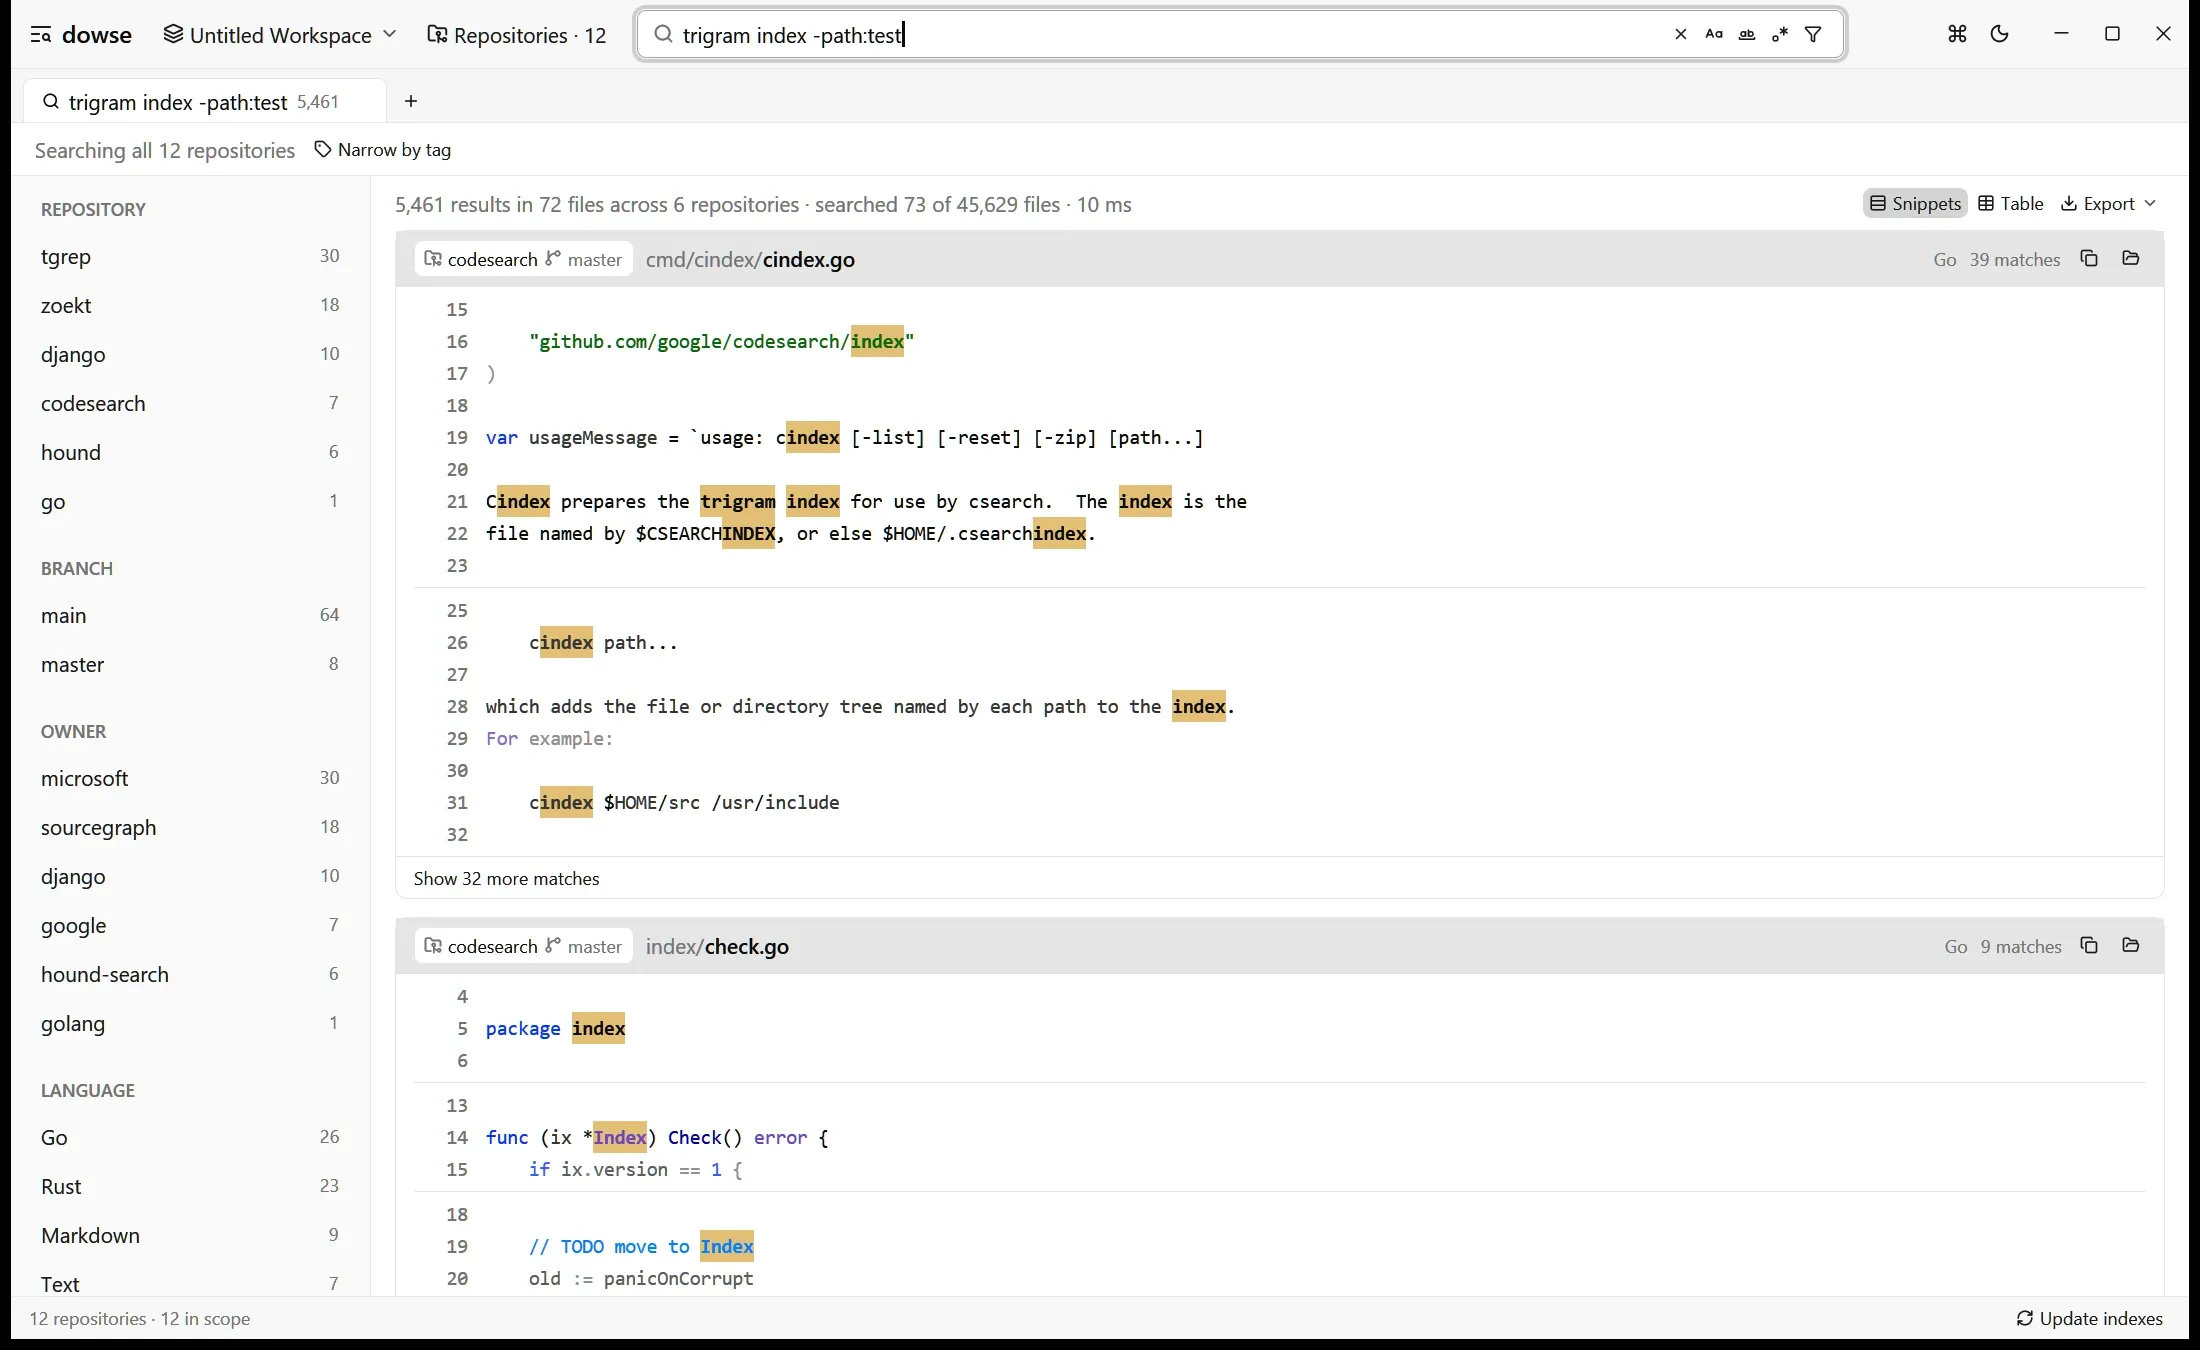
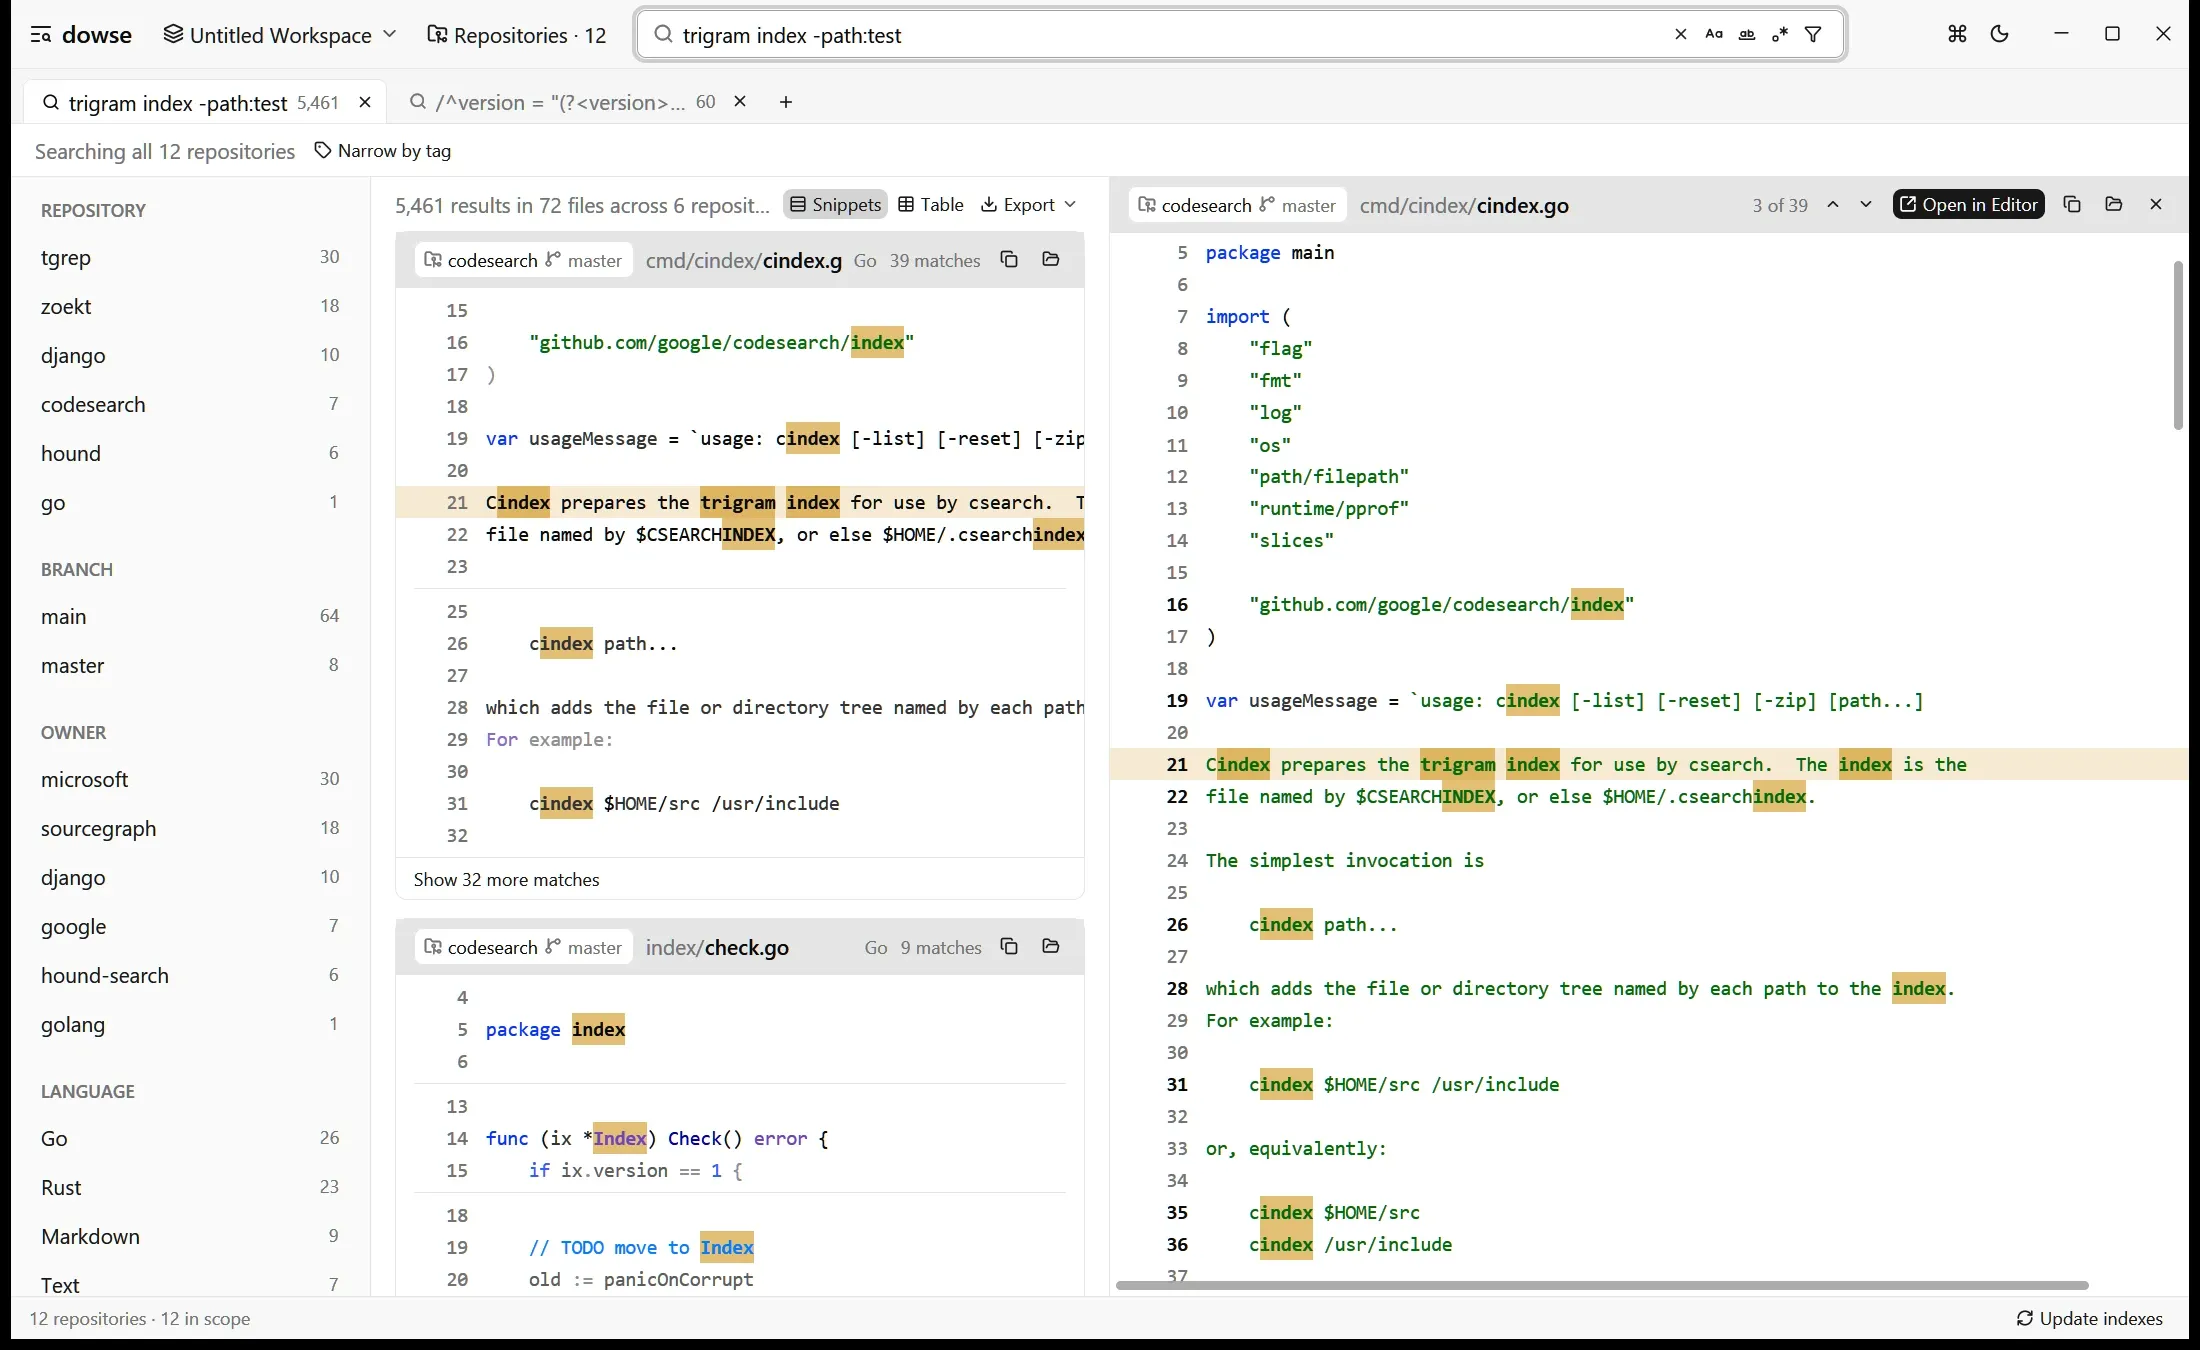
Les résultats s’affichent sous forme d’extraits avec coloration syntaxique assurée par tree-sitter. Un clic sur une ligne ouvre un aperçu du fichier complet à côté de la liste des résultats. La touche F4 permet de parcourir successivement les correspondances, tandis que Ctrl+Clic ouvre directement la ligne ciblée dans VS Code, Cursor, Zed ou Sublime Text.
Les tags définissent le périmètre, les facettes affinent les résultats
Un espace de travail regroupe plusieurs dépôts, sur le modèle des workspaces de VS Code, et s’enregistre sous la forme d’un fichier .dowse-workspace. Les dépôts peuvent recevoir des étiquettes (tags) : des libellés simples comme mirror ou dev, ou des paires clé-valeur comme owner:alice ou project:billing. De plus, chaque dépôt se voit automatiquement attribuer l’étiquette branch:<nom> correspondant à sa branche active, mise à jour à chaque changement de branche.
La barre de périmètre permet de cocher les tags à inclure dans la recherche. Les tags d’un même groupe fonctionnent en disjonction OU (owner:alice ou owner:bob) ; les groupes distincts s’associent en conjonction ET (dev et owner:alice). Une fois les résultats obtenus, les facettes dénombrent les correspondances par dépôt, branche, tag, langage et dossier racine, en recalculant chaque total en fonction des filtres actifs, à l’image de grep.app.
Vue sous forme de tableau : les groupes de capture regex deviennent des colonnes
La vue en tableau (Alt+T) présente chaque correspondance sur une ligne structurée : dépôt, branche, chemin, ligne, colonne, langage, texte correspondant et contenu intégral de la ligne. Dès lors que l’expression régulière de votre requête comporte des groupes de capture nommés (named capture groups), chaque groupe est transformé en une colonne dédiée. Par exemple, la requête suivante extrait en un instant la liste de toutes les versions de crates utilisées dans vos dépôts :
/^version = "(?<version>[^"]+)"/ path:Cargo.toml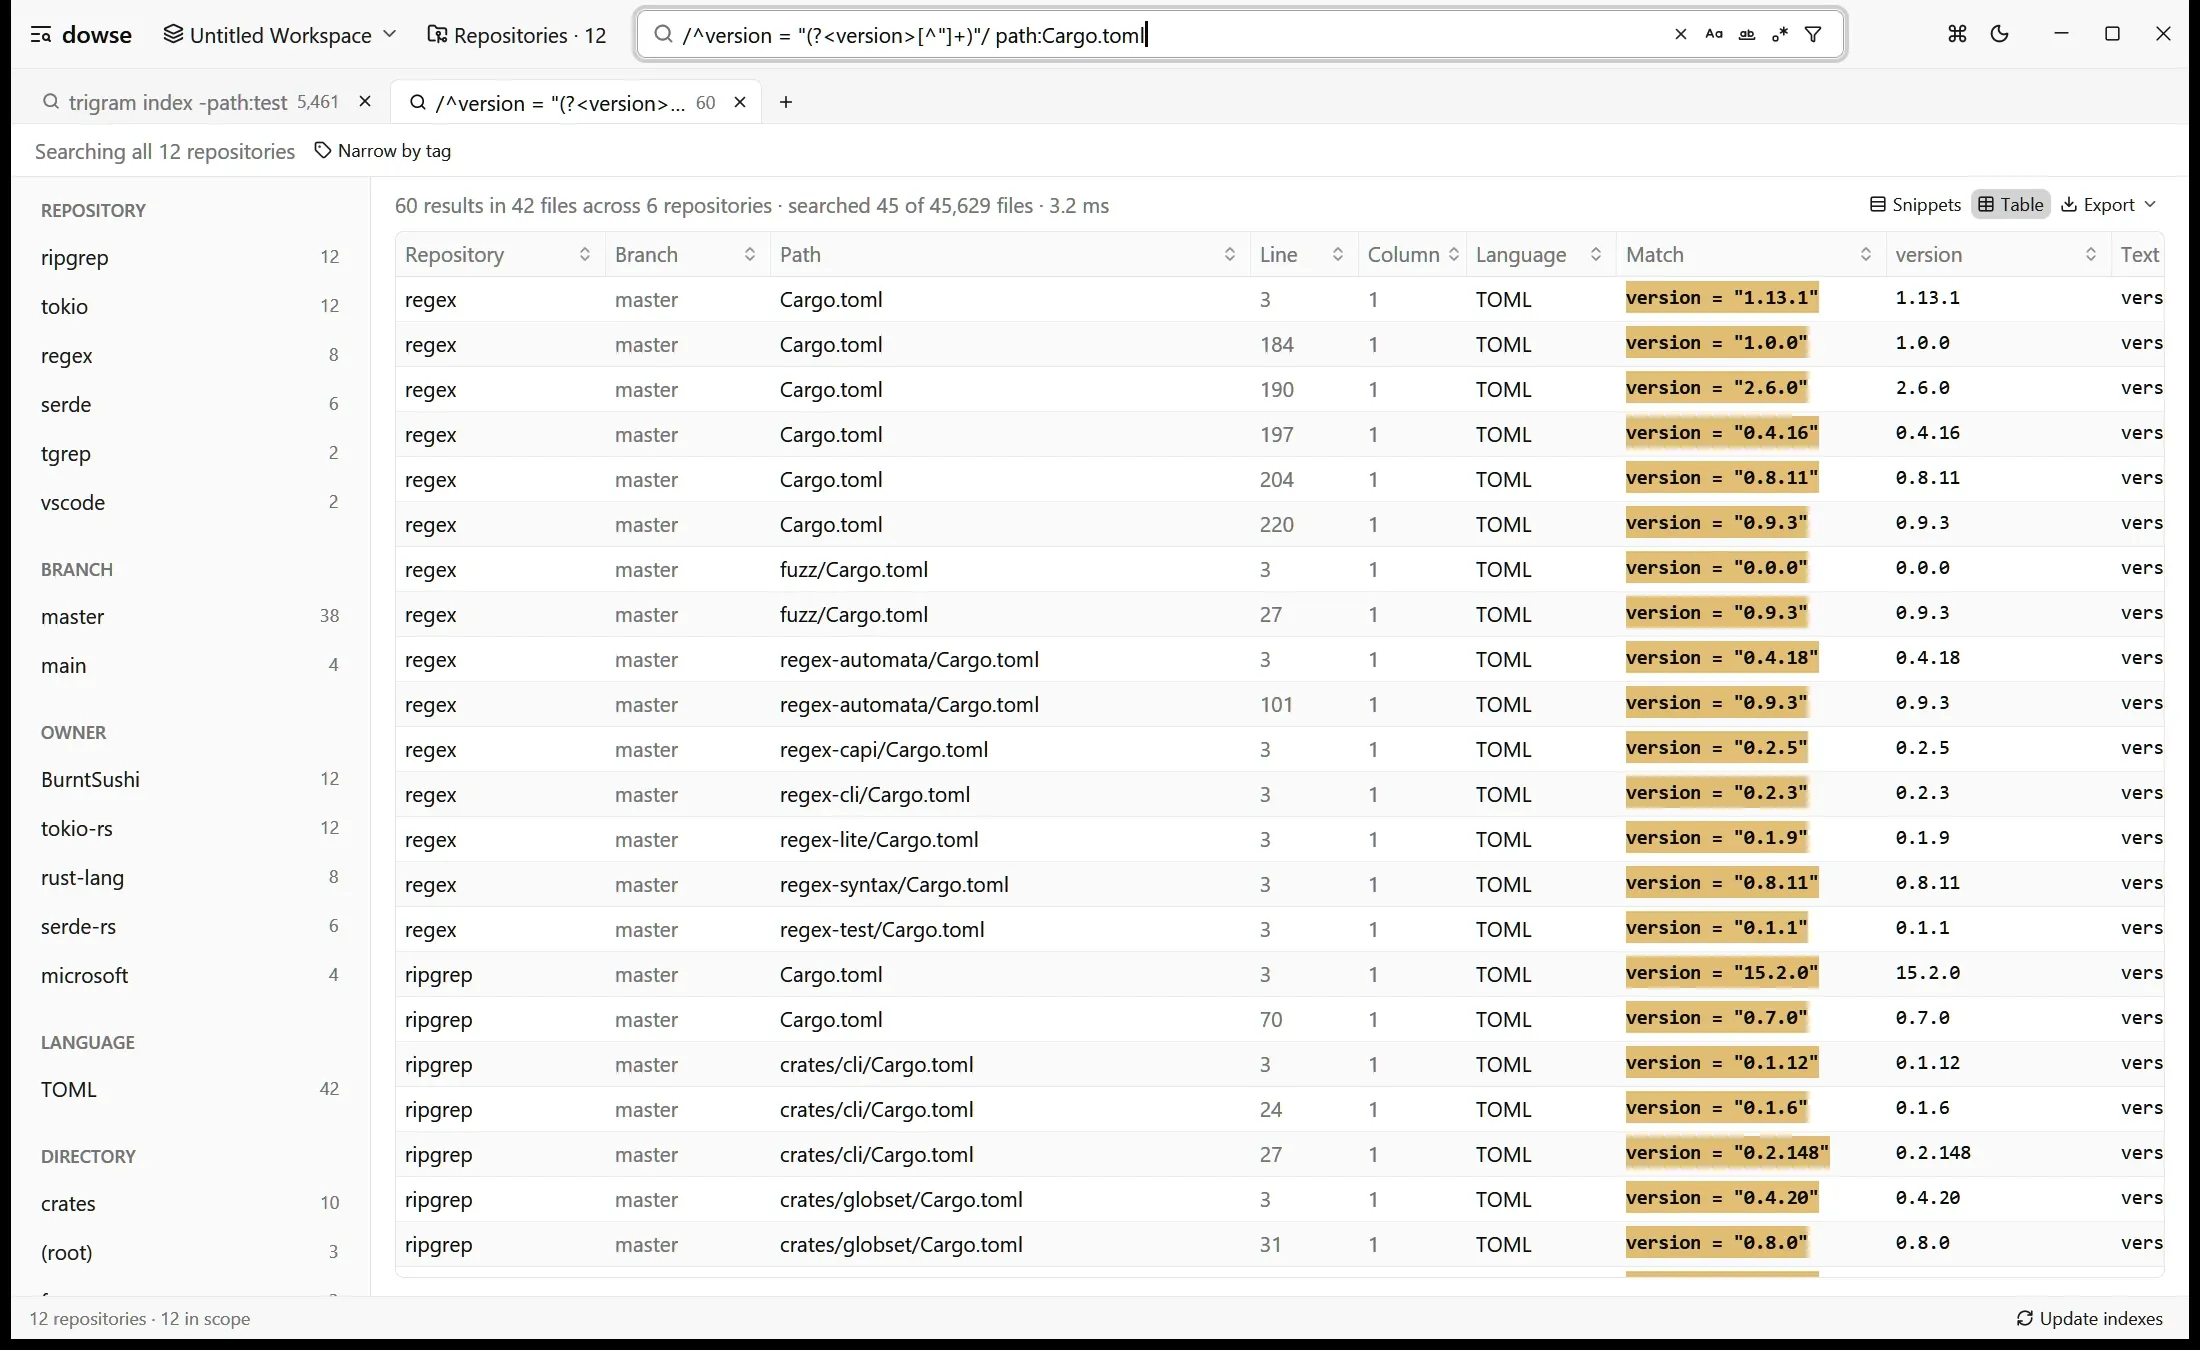
Alors que GitHub code search s’arrête net à 100 résultats, le tableau de dowse peut afficher jusqu’à environ 20 000 lignes. Vous pouvez trier selon n’importe quelle colonne, exporter les données au format CSV, TSV, Markdown ou JSON, ou les coller directement dans votre tableur habituel. Savoir « quels services appellent encore cette API obsolète » ou « quels niveaux de logs sont paramétrés sur l’ensemble de la flotte » se résume désormais à une simple table ordonnée plutôt qu’au défilement manuel de centaines de lignes.
Cloner toute une organisation GitHub et la garder synchronisée
La vue des dépôts interroge les dépôts d’un compte ou d’une organisation via la GitHub CLI, ce qui évite à dowse de manipuler le moindre identifiant : il suffit d’avoir exécuté gh auth login une seule fois dans votre terminal. La liste est récupérée de manière parallélisée ; une organisation de 2 000 dépôts s’affiche en quelques secondes. Sélectionnez-en quelques-uns ou la totalité, et dowse les clone en arrière-plan dans <dossier>/<owner>/<name>, leur associe l’étiquette owner:<owner> et lance leur indexation.
Par défaut, le clonage s’effectue en mode sans blobs (blobless clones) : l’historique complet des commits est conservé, mais seul le contenu des fichiers de la révision active est rapatrié. Ainsi, même les dépôts volumineux se téléchargent très vite sans compromettre l’accès à l’historique git.
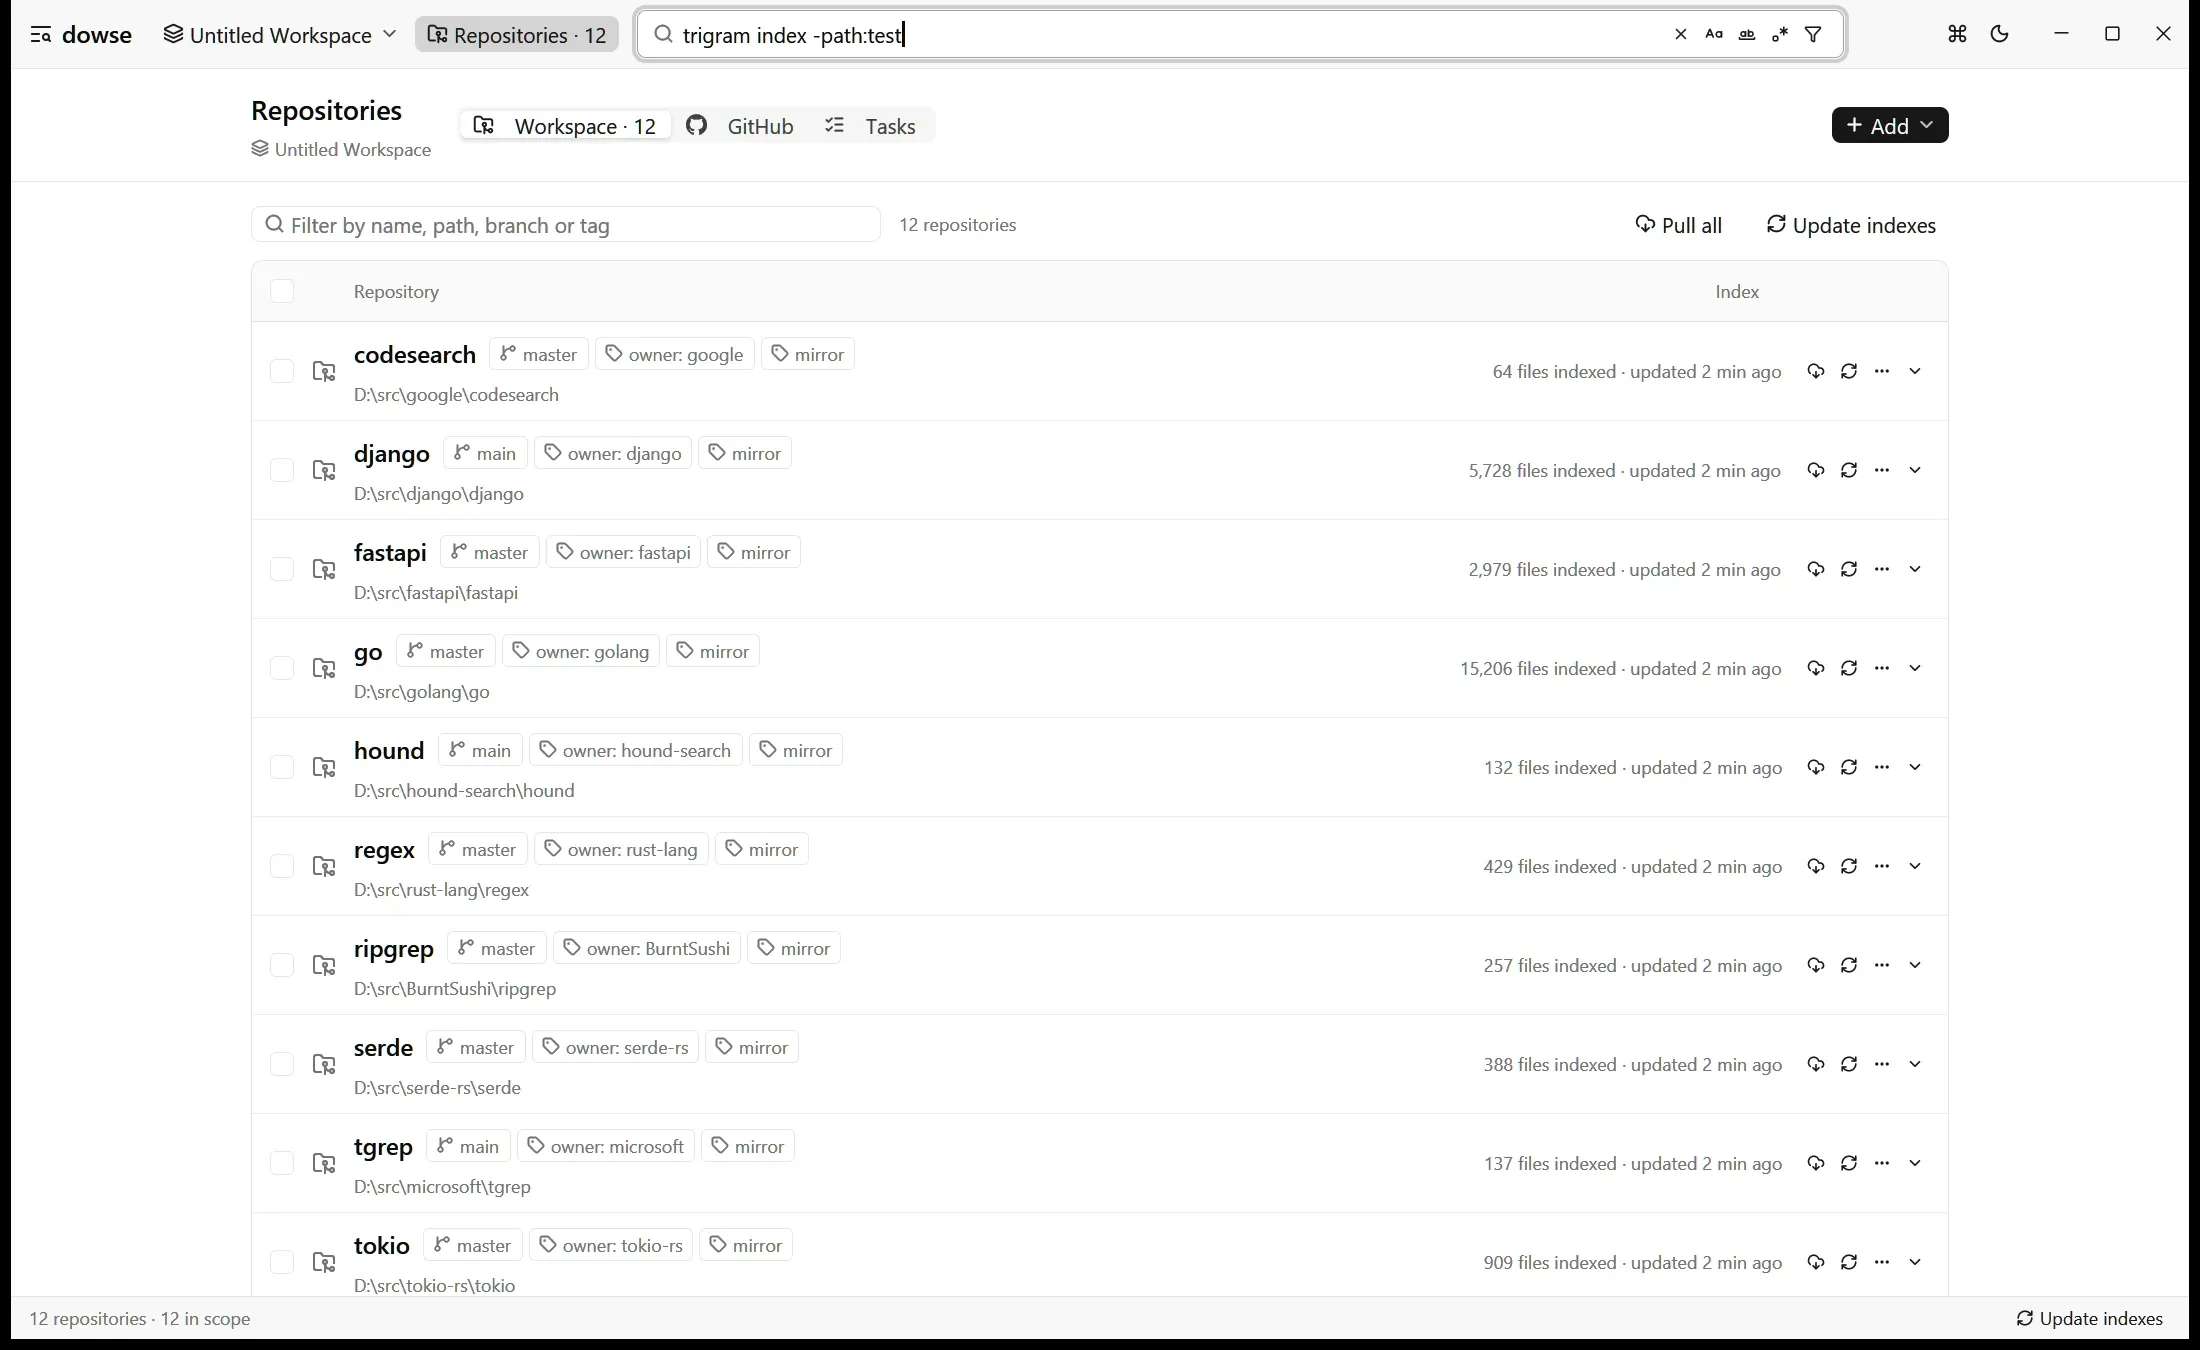
En associant un intervalle de synchronisation à un dépôt (15m, 1h, 3d), dowse effectue des pulls réguliers. L’opération lance un fetch depuis origin et n’applique une avance rapide (fast-forward) que si toutes les conditions de sécurité sont réunies : la branche par défaut est active, aucun fichier suivi n’est modifié et aucun commit local n’attend d’être poussé. Si une condition manque, dowse s’en tient au fetch et affiche clairement la raison (on feature/x, not main, uncommitted changes). Il ne réalise jamais de merge, de rebase ou de stash automatique : vous pouvez donc y intégrer sans risque vos copies de travail quotidiennes en plus de vos miroirs.
Propulsé par tgrep, le grep à trigrammes conçu par Microsoft
Le moteur au cœur de dowse est tgrep, l’outil grep haute performance indexé par trigrammes que Microsoft a publié cette année en open source et qui motorise la recherche de code dans la GitHub Copilot CLI. Un index de trigrammes recense les fichiers contenant chaque séquence possible de trois caractères. Lorsqu’une requête est soumise, tgrep la décompose en trigrammes, intersecte leurs listes d’occurrences et ne charge depuis le disque que les rares fichiers susceptibles de correspondre, avant de les soumettre au moteur d’expressions régulières. Zoekt et, avant lui, Google Code Search, reposent sur le même principe. Dans les bancs d’essai officiels de Microsoft, tgrep s’est montré plus rapide que ripgrep dans 17 combinaisons de dépôts et de plateformes sur 18, avec des gains atteignant un facteur de 51,9.
Pour les captures de cet article, dowse a indexé douze dépôts open source clonés depuis GitHub : tgrep, ripgrep, Zoekt, Google codesearch, Hound, tokio, serde, regex, VS Code, Django, FastAPI et Go, pour un total de 45 629 fichiers. La requête trigram index -path:test trouve 72 fichiers répartis sur six dépôts ; pour y parvenir, dowse n’a eu à lire que 73 fichiers sur le disque, en tout juste 10 ms. La génération du tableau des versions de Cargo.toml a pris 3,2 ms. Sur un ensemble plus vaste de 42 000 fichiers (1,3 Go de sources en Rust), la constitution initiale de l’index demande environ 6 secondes et les requêtes courantes s’exécutent en 20 à 60 ms.
tgrep pris isolément est conçu pour indexer un arbre de répertoires unique et l’interroger en ligne de commande ou via un serveur local. dowse fédère de multiples arbres de code derrière un point d’entrée unique et ajoute ce que cette échelle exige : analyse de la syntaxe GitHub, étiquettes et facettes multi-dépôts, vue tabulaire, prévisualisation intégrée, clonage et synchronisation GitHub. Les index restent au format natif de tgrep dans le dossier .tgrep de chaque dépôt (exactement à l’emplacement utilisé par tgrep index et tgrep serve), permettant à dowse et au binaire tgrep en CLI de partager le même index.
Un index toujours à jour sans reconstruction complète
Un index n’a de valeur que s’il colle fidèlement à l’état des fichiers sur disque. dowse évite ainsi toute reconstruction globale laborieuse :
- Un observateur de fichiers (file watcher) dédié suit les modifications survenues depuis la dernière compilation de l’index, et les recherches lisent immédiatement ces fichiers à chaud. Qu’il s’agisse d’un
git pullsur un miroir ou d’une sauvegarde enregistrée il y a une seconde dans votre éditeur, la modification apparaît dès la recherche suivante. - À l’ouverture d’un dépôt, dowse identifie automatiquement les ajouts, suppressions ou renommages survenus lorsque l’application était fermée.
- La mise à jour d’un index ne parcourt que les fichiers altérés et les injecte en continu dans une copie de l’index. Pour un dépôt de 245 000 fichiers doté d’un index de 1,7 Go, cette passe dure environ 10 secondes, là où une génération intégrale prendrait 9 minutes. Et les recherches demeurent opérationnelles pendant tout le traitement.
L’interface de l’application de bureau est native, développée avec GPUI, le framework de rendu GPU qui propulse l’éditeur Zed. Aucun navigateur web ni runtime Electron ne vient alourdir l’ensemble.
Une ligne de commande conçue pour les développeurs et les agents de code
Les sous-commandes telles que dowse search ou dowse repos dialoguent directement avec l’application de bureau en cours d’exécution, bénéficiant immédiatement de ses index chauds en mémoire et de ses observateurs de fichiers. Si l’application n’est pas encore lancée, la première commande démarre discrètement un processus d’arrière-plan sans fenêtre.
dowse search 'parse_config lang:rust' # cherche dans tous les dépôts gérésdowse search --here 'parse_config' # limite la recherche au dépôt courantdowse search -t owner:my-org -l 'LegacyClient' # chemins uniquement, sur les dépôts d'un comptedowse repos clone --from my-org --pull-every 1hLe format de sortie est calibré aussi bien pour l’œil humain que pour des agents de codage IA comme Claude Code, Codex ou Cursor. Lorsqu’un agent lance un grep naïf sur une arborescence gigantesque, il gaspille son temps en accès disque et sature sa fenêtre de contexte avec des pages de texte brut. tgrep règle la première partie du problème au sein de la GitHub Copilot CLI ; dowse fournit à n’importe quel agent ce même index ultra-rapide sur l’ensemble de vos dépôts, avec une maîtrise stricte du volume de sortie :
-
Les correspondances vont sur la sortie standard (stdout) ; les totaux, mesures de temps et remarques s’affichent sur stderr. Le code de retour est 0 en cas de succès et 1 si aucune correspondance n’est trouvée.
-
Par défaut, la sortie est plafonnée à 100 lignes de résultats et 20 par fichier, avec un bilan en pied de page. Si les résultats sont tronqués, le pied de page suggère des filtres précis pour restreindre la recherche, assortis du nombre de fichiers conservés :
narrow with: repo:api (120) language:Rust (80) path:src/** (64) -
L’option
--jsonrenvoie un objet structuré par fichier ainsi qu’un résumé ;--table csvexporte directement les lignes de la vue en tableau en CSV. -
dowse guideaffiche un guide pratique destiné aux agents. En l’insérant dans votreAGENTS.mdouCLAUDE.md, vous permettez à votre agent d’explorer tous vos dépôts locaux sans rester confiné au répertoire depuis lequel il a été exécuté.
Comparatif de dowse avec tgrep, Sourcegraph, Zoekt, GitHub code search et Entrian Source Search
| Critère | dowse | tgrep | GitHub code search | Sourcegraph | Zoekt | Entrian Source Search |
|---|---|---|---|---|---|---|
| Environnement | Machine locale | Machine locale | Sur github.com | Serveur dédié | Serveur dédié | Dans Visual Studio |
| Périmètre | Multiples clones locaux, toute branche, modifications non commitées | Un seul arbre de dossiers | Dépôts GitHub, branche par défaut uniquement | Forges connectées | Dépôts indexés | Fichiers de la solution en cours |
| Syntaxe | GitHub code search | Regex, typé grep | GitHub code search | Propre à Sourcegraph | Propre à Zoekt | Propre à Entrian |
| Indexation | Trigrammes (tgrep), suivi temps réel par watcher | Trigrammes | Propriétaire GitHub | Zoekt | Trigrammes | Plein texte |
| Interface | Application de bureau et CLI | CLI et serveur local | Web | Web | Web et API | Panneau dans l’EDI |
| Tarification | Gratuit, licence MIT | Gratuit, licence MIT | Inclus avec GitHub | Commercial | Gratuit, Apache-2.0 | Licence payante par développeur |
En résumé : si vous cherchez le grep le plus véloce au terminal dans un seul dépôt, tournez-vous vers tgrep. Si votre équipe a besoin d’une recherche transversale partagée dans le navigateur, déployez Sourcegraph ou une instance Zoekt. Si tout votre code réside sur GitHub et que la branche principale vous suffit, GitHub code search est déjà disponible. Et si vous souhaitez pouvoir explorer en une fraction de seconde des dizaines de dépôts locaux sur n’importe quelle branche, avec vos modifications de travail en cours et sans devoir héberger de serveur, dowse est exactement la solution pensée pour vous.
Télécharger dowse
La page des versions propose en permanence les binaires compilés les plus récents, avec leurs sommes de contrôle dans SHA256SUMS. Chaque archive suit le schéma dowse, suivi du numéro de version et de votre plateforme :
| Plateforme | Archive |
|---|---|
| Windows (x64) | …-windows-x86_64.zip |
| macOS 11+ (Apple silicon et processeurs Intel) | …-macos-universal.zip |
| Linux (x64) | …-linux-x86_64.tar.gz |
| Linux (arm64) | …-linux-aarch64.tar.gz |
Une fois l’archive décompressée, ajoutez simplement les répertoires contenant vos dépôts :
dowse ~/src ~/mirrorsLorsqu’un dossier contient plusieurs dépôts Git, dowse les détecte et les intègre automatiquement. Sous Windows, la vue des dépôts peut également inscrire l’option « Add to dowse » dans le menu contextuel de l’Explorateur de fichiers.
Les exécutables n’étant pas signés avec un certificat commercial d’entreprise, Windows SmartScreen ou macOS Gatekeeper peuvent afficher un avertissement au premier lancement ; le fichier README précise la procédure pour autoriser l’ouverture. Pour compiler dowse à partir des sources, lancez simplement cargo run --release avec une version stable récente de Rust.
Foire aux questions (FAQ)
dowse constitue-t-il une alternative à Sourcegraph ?
Pour un développeur individuel explorant ses propres clones en local, oui. dowse répond au cas d’usage central de Sourcegraph : des recherches ultra-rapides par regex ou texte brut sur de multiples dépôts, sans exiger de serveur. En revanche, il ne vise pas à reproduire la navigation sémantique (code intelligence), les campagnes de modifications automatiques (batch changes) ou l’interface web collective destinées aux organisations.
dowse n’est-il qu’une simple interface graphique pour tgrep ?
En partie. dowse s’appuie sur le format d’index de tgrep et lit comme écrit dans les mêmes répertoires .tgrep, jouant ainsi le rôle de frontal de bureau pour tgrep. Cependant, dowse permet de rechercher sur de multiples dépôts en une seule requête, interprète la syntaxe de GitHub code search, et propose des tags, des facettes, une vue en tableau, un aperçu de code intégré ainsi que le clonage et la mise à jour programmée depuis GitHub, autant de fonctionnalités absentes de tgrep.
En quoi dowse se distingue-t-il de Zoekt ?
Tous deux exploitent des index inversés par trigrammes. Zoekt est un moteur conçu comme un service d’infrastructure autonome, devant être maintenu en permanence et alimenté en index par un orchestrateur externe. dowse est une application autonome qui gère elle-même l’indexation de vos dépôts locaux, assure leur fraîcheur via des observateurs d’événements de fichiers et des passes incrémentales, et met à disposition une interface graphique soignée ainsi qu’un CLI taillé pour les flux modernes.
Peut-on effectuer des recherches locales avec la syntaxe de GitHub code search ?
Oui. dowse prend en charge les éléments clés de la syntaxe de GitHub code search : les opérateurs AND, OR, NOT, les phrases exactes entre guillemets, les expressions régulières entre barres obliques /regex/, ainsi que les filtres path:, language:, repo: et branch:, avec le préfixe - pour les exclusions.
dowse prend-il en compte les modifications non validées et les branches secondaires ?
Oui. Comme dowse interroge directement les fichiers résidant sur votre disque, il parcourt fidèlement la branche active et les modifications qui n’ont pas encore fait l’objet d’un commit. Chaque dépôt recevant un tag indiquant sa branche en cours, branch:main vous permet de restreindre instantanément votre recherche aux branches principales.
Existe-t-il une alternative à Entrian Source Search utilisable hors de Visual Studio ?
dowse n’est pas une extension d’EDI, mais une application de bureau et CLI autonome capable de relayer les résultats vers l’éditeur de votre choix, comme VS Code, Cursor, Zed ou Sublime Text. Il opère de façon globale sur vos dépôts sans se restreindre à une solution unique, et demeure entièrement libre et gratuit.
dowse transmet-il mon code vers l’extérieur ?
Absolument pas. Les index sont cantonnés au répertoire .tgrep de chaque dépôt et toutes les requêtes sont exécutées exclusivement sur votre machine locale. Les seuls échanges réseau correspondent aux commandes Git et GitHub CLI que vous déclenchez explicitement (recensement des dépôts d’une organisation, clonage initial ou mise à jour périodique).
dowse est disponible sur GitHub. S’il vous permet d’accélérer votre travail, une étoile sur le dépôt aide d’autres développeurs à le découvrir ; en cas de bug ou de suggestion, n’hésitez pas à ouvrir une issue.