dowse: Lokale Alternative zu Sourcegraph und GitHub Code Search
dowse durchsucht den Code vieler Git-Repositories gleichzeitig – wahlweise über eine Desktop-Anwendung oder direkt über die Kommandozeile. Was GitHub code search und grep.app für GitHub leisten, bringt dowse auf die eigene Festplatte: Ein einziges Suchfeld, alle Repositories, Ergebnisse im Millisekundenbereich. Es nutzt exakt dieselbe Abfragesyntax wie GitHub code search, basiert auf Microsofts quelloffenem Trigramm-Grep tgrep, verwaltet wie Zoekt einen Index pro Repository und kommt vollkommen ohne Server aus.
dowse läuft unter Windows, macOS und Linux. Es ist kostenlos und steht unter der MIT-Lizenz.
Der benötigte Code liegt selten in einem einzigen Repository
Wenn man herausfinden will, wo eine Funktion aufgerufen wird, wo ein Konfigurationsschlüssel gelesen wird oder welche Services noch auf einer veralteten Bibliotheksversion festhängen, ist die Antwort meist über Dutzende Repositories verstreut: die aktuellen Arbeitskopien, Mirrors anderer Team-Services und eingebundene Third-Party-Bibliotheken. Bestehende Suchwerkzeuge decken jeweils nur Teilbereiche ab:
- GitHub code search ist schnell und bietet eine hervorragende Suchsyntax, durchsucht aber ausschließlich Code auf GitHub, beschränkt sich auf den jeweiligen Standard-Branch und liefert maximal 100 Ergebnisse pro Anfrage. Der Feature-Branch, an dem man gerade sitzt, ungesicherte lokale Änderungen oder Repositories auf anderen Git-Hostern bleiben außen vor.
- grep.app durchsucht nur öffentliche GitHub-Repositories. Interner Unternehmenscode hat dort nichts zu suchen.
- Sourcegraph ist zweifellos die umfassendste Plattform für Code-Suche samt Code-Navigation und Batch Changes. Es ist jedoch ein serverseitiges Schwergewicht: Jemand muss es ausrollen, an Code-Hosts anbinden und im Betrieb halten. Für ein großes Entwicklerteam ist das gut investiertes Geld; für einen einzelnen Entwickler am Laptop schlicht zu viel Ballast, um nur lokale Ordner zu durchsuchen.
- Zoekt, die Trigramm-Engine hinter Sourcegraph, ist Open Source und extrem schnell. Aber auch hierbei handelt es sich um Indexer und Server, die man aufsetzen, betreiben und füttern muss.
- Entrian Source Search rüstet Visual Studio mit einem Volltextindex aus, ist aber fest an die IDE gekoppelt und kostet Lizenzgebühren pro Entwickler.
- ripgrep und
git grepbenötigen keinerlei Setup, lesen bei jeder Suche jedoch jede Datei von Grund auf neu und immer nur innerhalb eines Verzeichnisbaums. Bei fünfzig Repositories ist es mit der unmittelbaren Antwort vorbei.
Ich wollte das, was mir GitHub code search auf github.com bietet, direkt auf meiner eigenen Festplatte: über alle Klone hinweg – über Mirrors, die auf main stehen, über meine aktiven Arbeitskopien und inklusive aller ungespeicherten oder uncommitteten Änderungen. Genau das ist dowse.
Was dowse leistet
GitHub-Code-Search-Syntax auf den eigenen Klonen
Suchanfragen werden direkt während des Tippens ausgewertet – in vertrauter GitHub-Syntax. Begriffe werden dabei pro Datei logisch verknüpft, nicht bloß zeilenweise. Eine Suche nach parse config findet somit Dateien, die beide Wörter irgendwo im Inhalt aufweisen, und hebt im Ergebnis die Zeilen hervor, die mindestens einen der Begriffe enthalten.
parse config Dateien, die beide Begriffe enthaltenparse OR config Dateien, die mindestens einen Begriff enthaltenparse NOT test parse enthalten, test jedoch ausschließen"fn main()" Exakte Zeichenfolge/fn \w+_test/ Zeile passend zum regulären Ausdruckpath:src/*.rs language:rust Pfad-Glob und Sprachfilterrepo:api branch:main Eingrenzung auf Repositories und Branches-path:tests -lang:md AusschlusskriterienBesteht eine Abfrage ausschließlich aus Qualifikatoren (wie path:*.proto), listet dowse die Trefferdateien auf, ohne deren Inhalt überhaupt einlesen zu müssen. Groß-/Kleinschreibung (Match Case), ganze Wörter (Whole Word) und reguläre Ausdrücke lassen sich per Tastenkürzel umschalten (Alt+C, Alt+W, Alt+R).
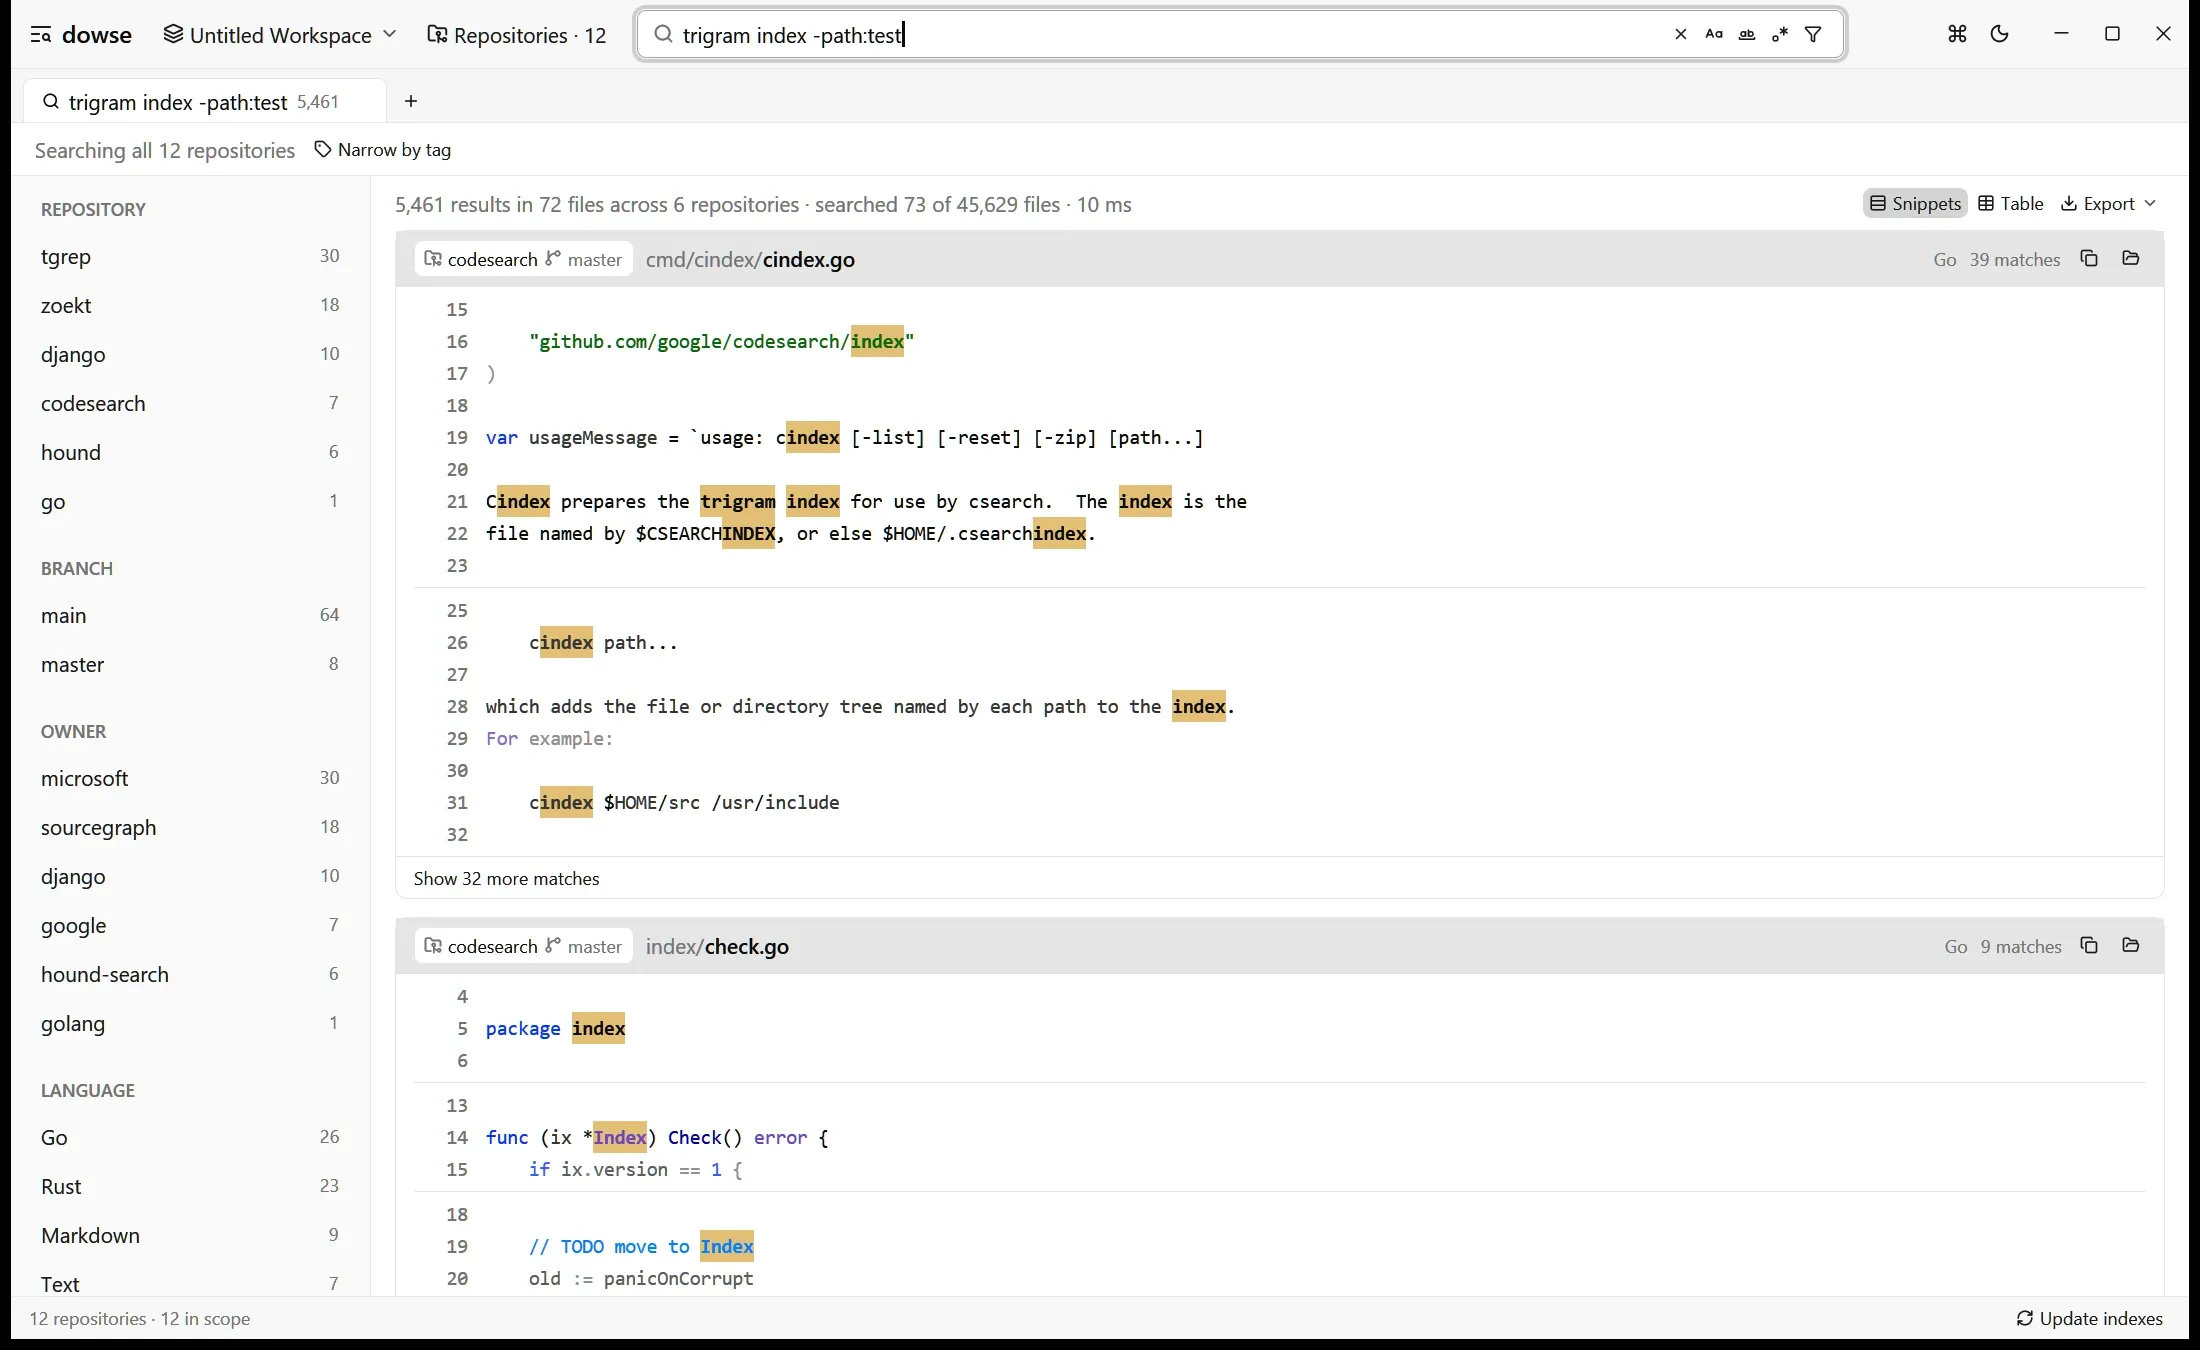
Ergebnisse werden als Code-Ausschnitte mit Tree-Sitter-Syntax-Highlighting dargestellt. Ein Klick auf eine Zeile öffnet die Datei-Vorschau direkt neben der Trefferliste, mit F4 springt man durch die Treffer, und per Strg+Klick öffnet sich die entsprechende Zeile unmittelbar in VS Code, Cursor, Zed oder Sublime Text.
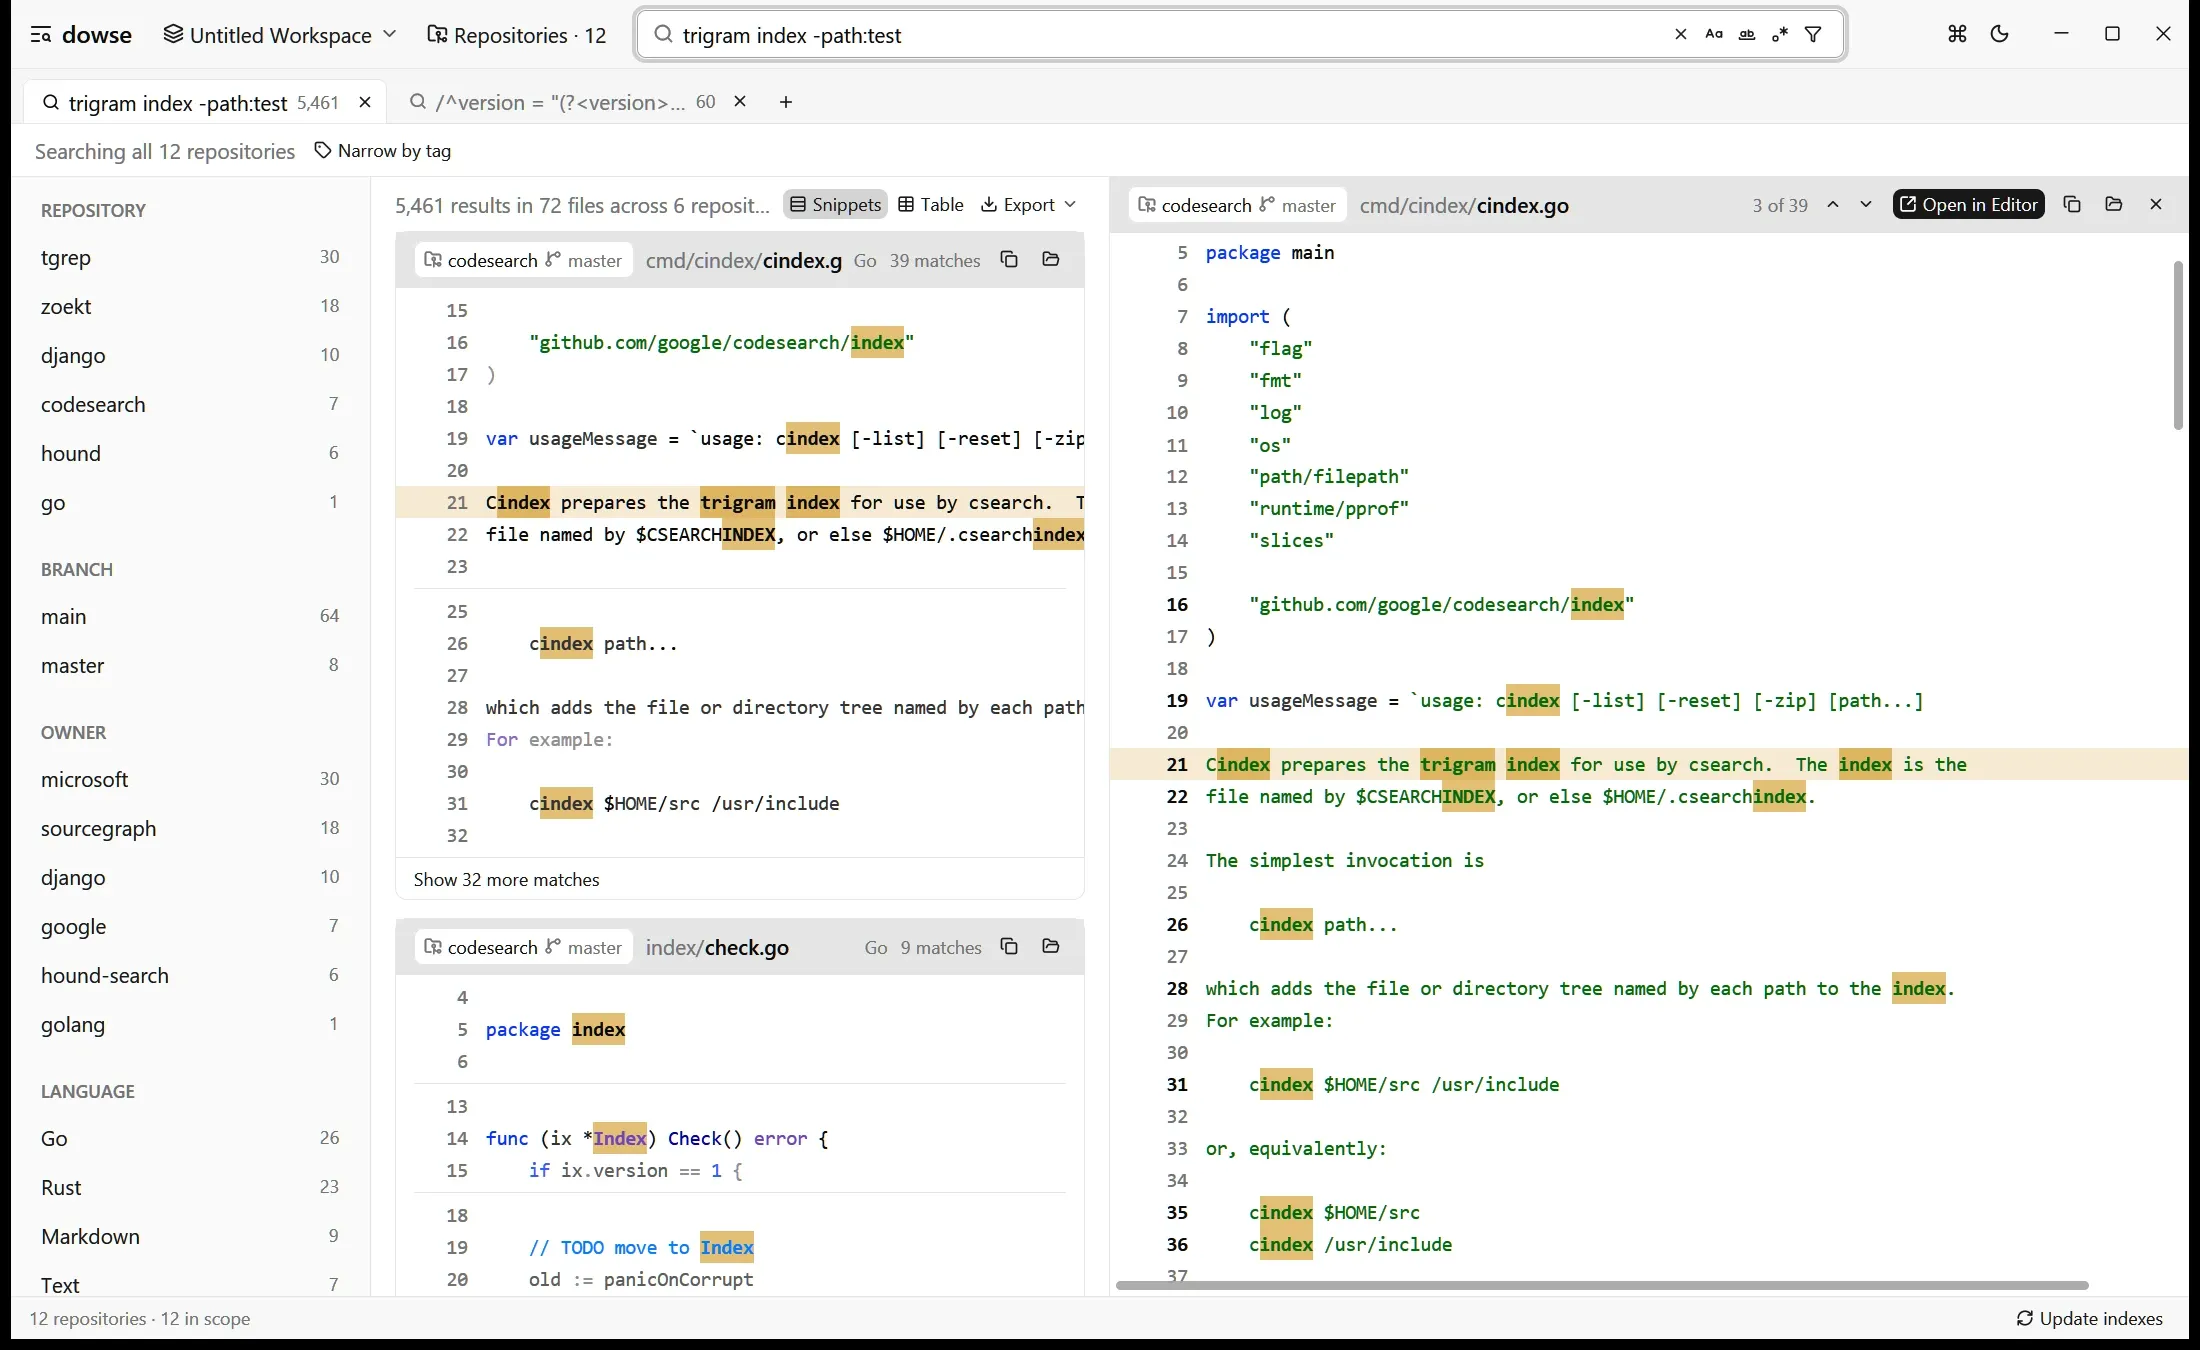
Tags bestimmen den Suchbereich, Facetten grenzen Treffer ein
Ein Workspace bündelt eine Menge von Repositories (ähnlich wie in VS Code) und wird als .dowse-workspace-Datei gespeichert. Repositories lassen sich mit Tags versehen: mit einfachen Labels wie mirror oder dev oder als Schlüssel-Wert-Paare wie owner:alice oder project:billing. Jedes Repository erhält zudem automatisch ein Tag branch:<name> für den aktuell ausgecheckten Branch, das bei Branch-Wechseln sofort aktualisiert wird.
Über die Scope-Leiste wählt man die zu durchsuchenden Tags aus. Tags innerhalb derselben Gruppe wirken als ODER-Verknüpfung (owner:alice oder owner:bob); verschiedene Gruppen filtern als UND-Verknüpfung gegeneinander (dev und owner:alice). Liegen die Ergebnisse vor, schlüsseln Facetten die Trefferzahlen wie bei grep.app nach Repository, Branch, Tag, Sprache und Hauptverzeichnis auf – jeweils unter Berücksichtigung aller aktiven Filter.
Tabellenansicht: Regex-Capture-Gruppen als strukturierte Spalten
Die Tabellenansicht (Alt+T) stellt jeden Zeilentreffer als eigene Tabellenzeile dar: Repository, Branch, Pfad, Zeile, Spalte, Programmiersprache, Match und vollständige Zeile. Enthält der reguläre Ausdruck der Abfrage benannte Capture-Gruppen (Named Capture Groups), wird jede Gruppe zu einer eigenen, nach ihr benannten Spalte. Folgende Abfrage verwandelt eine Suche im Handumdrehen in eine Übersicht aller verwendeten Crate-Versionen:
/^version = "(?<version>[^"]+)"/ path:Cargo.toml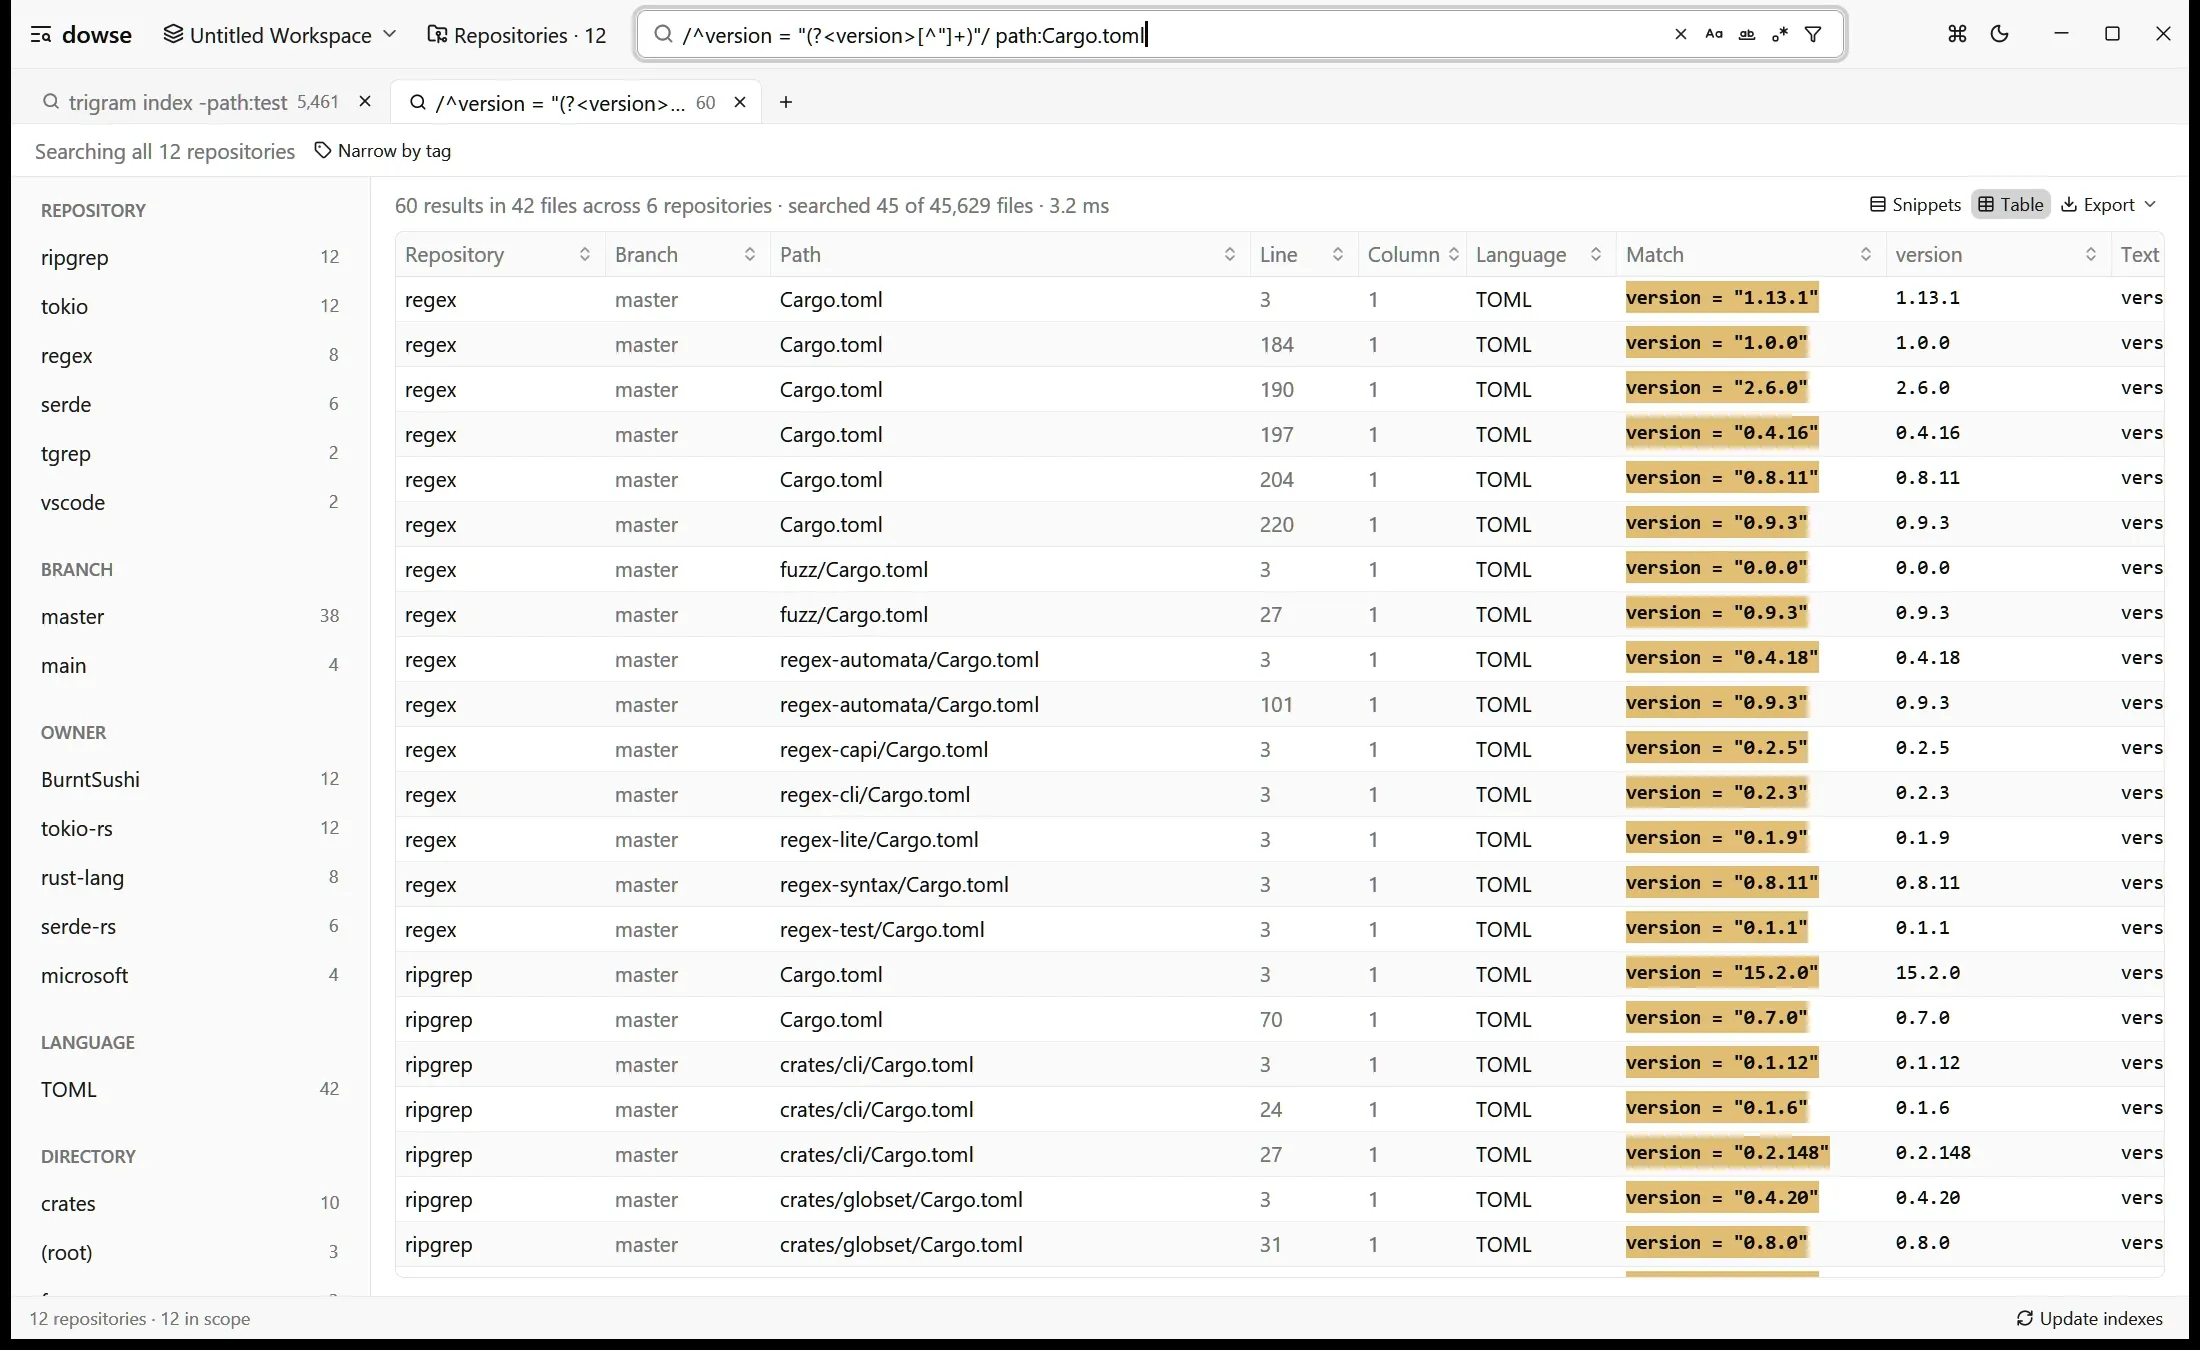
Während GitHub code search bei 100 Einträgen abbricht, fasst dowse hier bis zu rund 20.000 Zeilen. Die Tabelle lässt sich nach jeder Spalte sortieren und als CSV, TSV, Markdown oder JSON exportieren oder in eine Tabellenkalkulation einfügen. Fragen wie „Welche Services rufen noch diese API auf?“ oder „Wo sind welche Log-Level konfiguriert?“ beantwortet eine sortierbare Tabelle statt endlosem Scrollen durch Suchergebnisse.
Ganze GitHub-Organisationen klonen und aktuell halten
Die Repositories-Seite listet über das offizielle GitHub CLI alle Repositories eines Nutzers oder einer Organisation auf. dowse benötigt dafür niemals eigene Zugangsdaten: Einmal gh auth login im Terminal genügt. Die Listenabfrage erfolgt parallelisiert; selbst eine Organisation mit 2.000 Repositories ist in wenigen Sekunden geladen. Einzelne oder alle Repositories lassen sich auswählen, woraufhin dowse sie im Hintergrund nach <ordner>/<owner>/<name> klont, mit owner:<owner> taggt und sofort indiziert.
Klone sind standardmäßig blobless: Die vollständige Commit-Historie wird geladen, Dateiinhalte jedoch nur für den aktuell ausgecheckten Stand. So lassen sich selbst riesige Repositories zügig klonen, während Git-Log und -Historie voll erhalten bleiben.
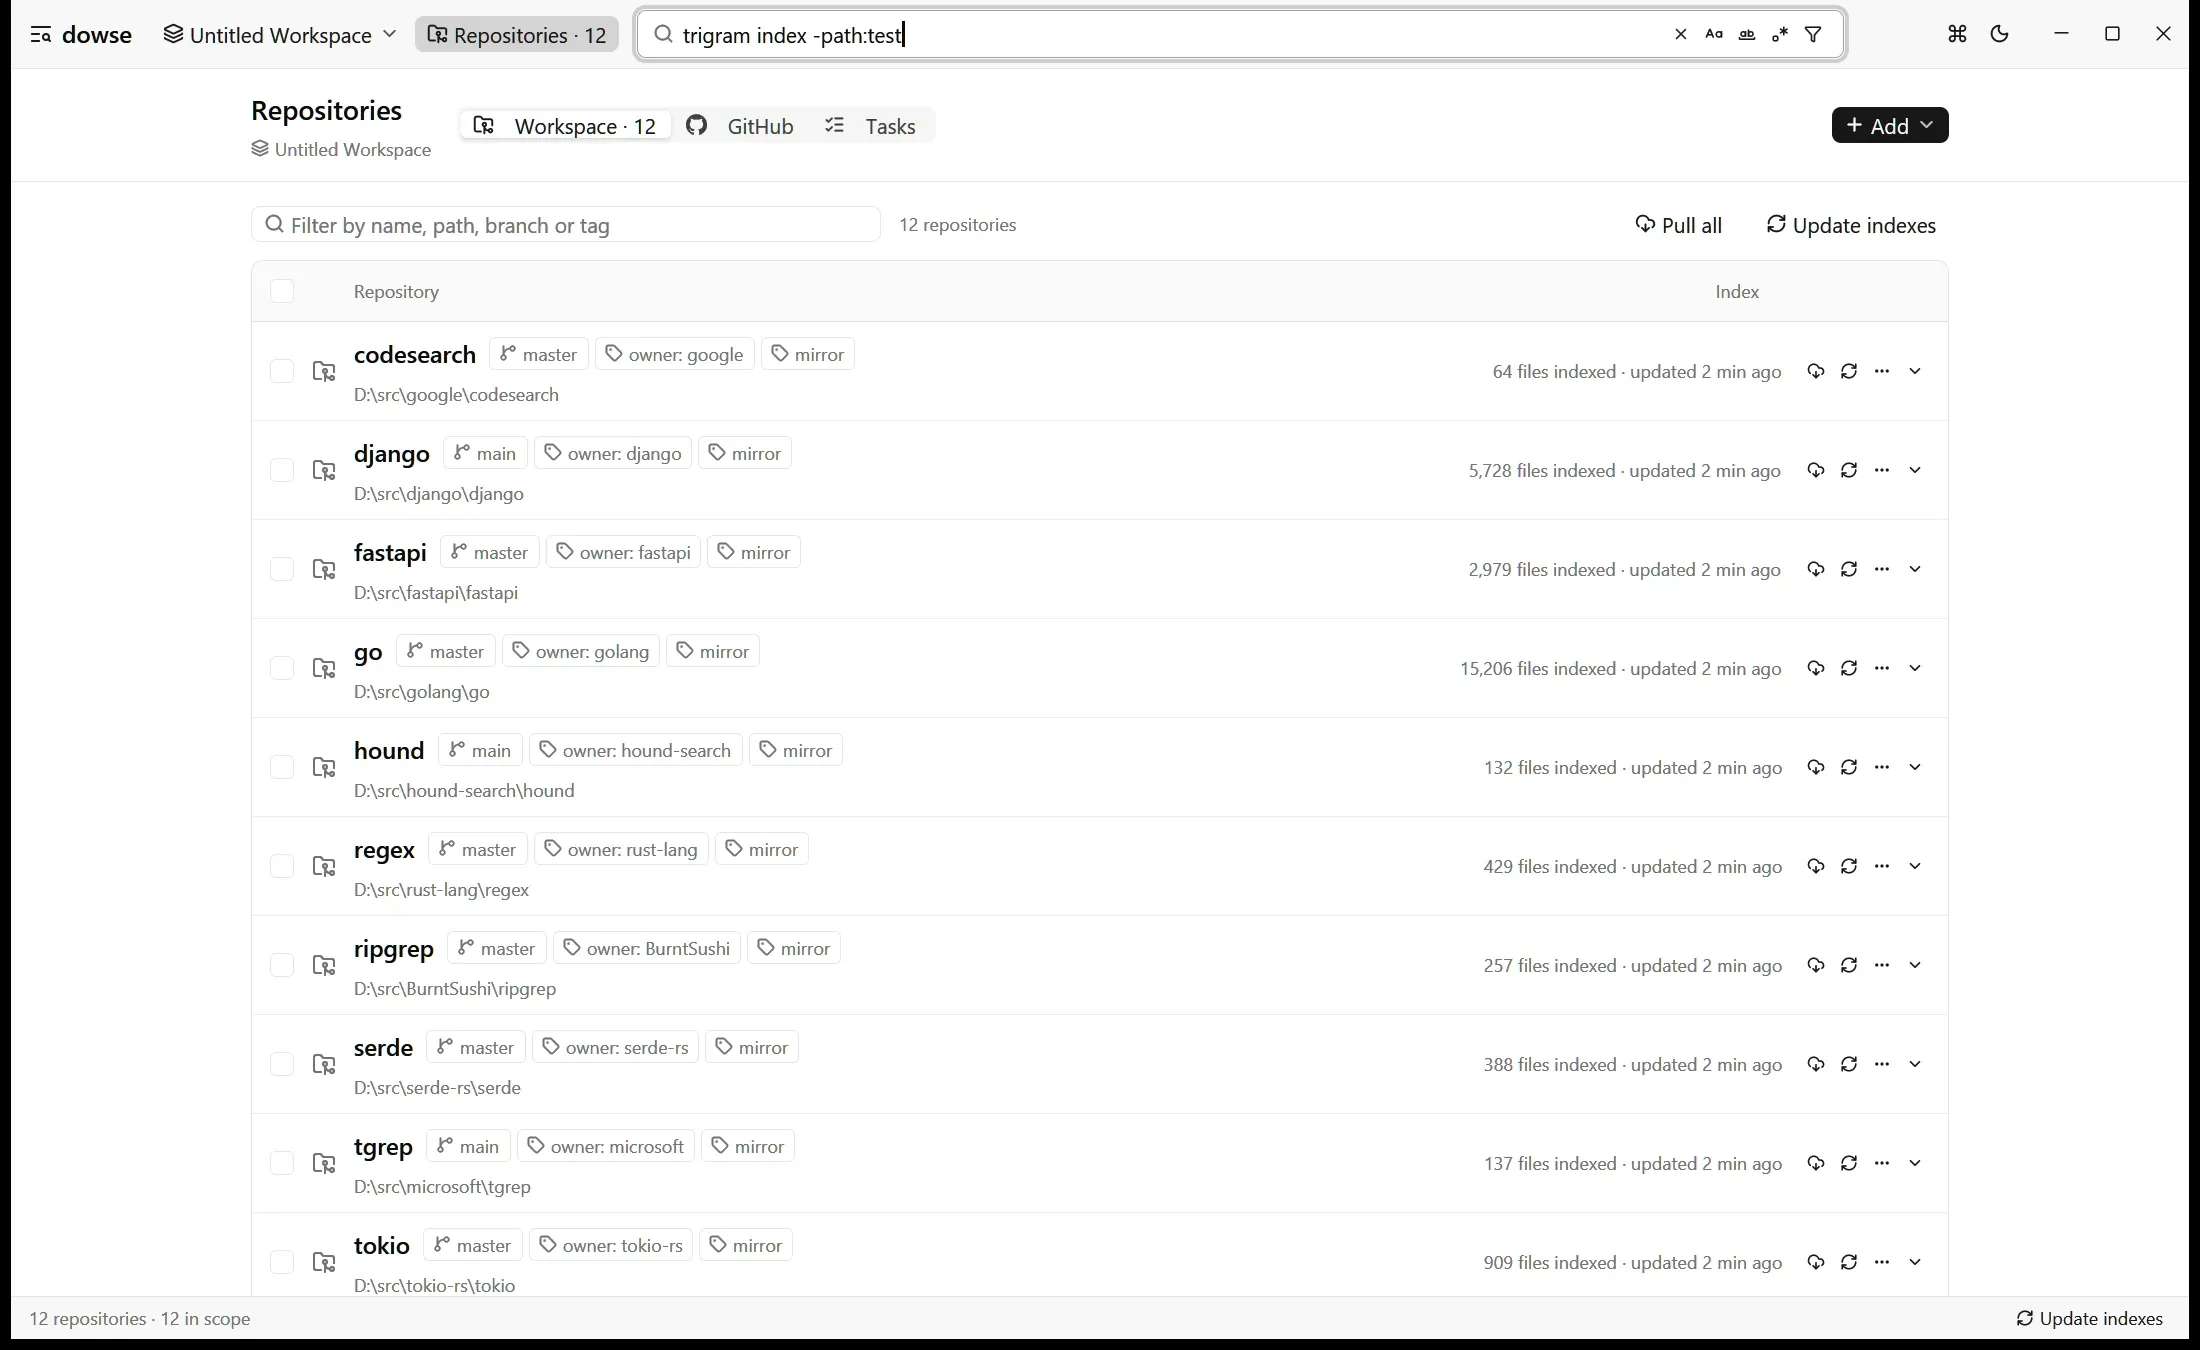
Wird für ein Repository ein Pull-Intervall hinterlegt (15m, 1h, 3d), synchronisiert dowse es im Hintergrund. Ein Pull führt ein Fetch von origin durch und macht nur dann einen Fast-Forward, wenn der Standard-Branch ausgecheckt ist, keine lokalen Änderungen vorliegen und keine lokalen Commits voraus sind. Andernfalls beschränkt sich dowse auf das Fetching und erläutert transparent den Grund (on feature/x, not main, uncommitted changes). Es führt niemals eigenmächtige Merges, Rebases oder Stashes durch – es ist also völlig sicher, auch aktive Arbeitskopien einzubinden.
Angetrieben von tgrep: Microsofts Trigramm-Grep
Das Herzstück von dowse ist tgrep, das extrem performante, trigramm-indizierte Grep-Werkzeug, das Microsoft dieses Jahr als Open Source veröffentlicht hat und das auch die Code-Suche der GitHub Copilot CLI antreibt. Ein Trigramm-Index speichert ab, in welchen Dateien jede beliebige 3-Zeichen-Sequenz vorkommt. Eine Abfrage wird in Trigramme zerlegt, deren Posting-Listen werden geschnitten, und nur die Dateien, die mathematisch überhaupt passen können, werden von der Festplatte gelesen und an die reguläre Regex-Engine übergeben. Zoekt und zuvor Google Code Search setzen auf dasselbe Prinzip. In Microsofts eigenen Benchmarks schlug tgrep ripgrep in 17 von 18 Repository- und Plattform-Kombinationen – um bis zum 51,9-fachen.
Für die Screenshots in diesem Artikel durchsuchte dowse zwölf von GitHub geklonte Open-Source-Projekte: tgrep, ripgrep, Zoekt, Google codesearch, Hound, tokio, serde, regex, VS Code, Django, FastAPI und Go – insgesamt 45.629 Dateien. Die Abfrage trigram index -path:test lieferte 72 Trefferdateien in sechs Repositories; um sie zu finden, musste dowse lediglich 73 Dateien von der Platte lesen und benötigte 10 ms. Die Cargo.toml-Versionstabelle dauerte 3,2 ms. In einem noch größeren Codebestand mit 42.000 Dateien (1,3 GB Rust-Quelltexte) ist der Index in etwa 6 Sekunden aufgebaut, und typische Anfragen dauern zwischen 20 und 60 ms.
tgrep selbst ist für die Durchsuchung eines einzelnen Verzeichnisbaums auf der Kommandozeile oder über einen lokalen Server konzipiert. dowse fasst viele Verzeichnisbäume hinter einer gemeinsamen Suchmaske zusammen und ergänzt genau das, was dafür nötig ist: GitHub-Syntax-Parsing, übergreifende Tags und Facetten, Tabellenansichten, Datei-Vorschau sowie Klonen und Synchronisieren via GitHub. Die Indizes sind standardkonforme tgrep-Indizes im Verzeichnis .tgrep des jeweiligen Repositories – derselbe Ort, den auch tgrep index und tgrep serve nutzen. dowse und das tgrep-CLI teilen sich somit denselben Index.
Stets aktueller Index ohne vollständigen Rebuild
Ein Suchindex nützt wenig, wenn er dem Dateisystem hinterherhinkt. dowse wartet daher nicht auf langwierige Komplett-Neuerstellungen:
- Ein File-Watcher pro Repository registriert alle Dateiänderungen seit dem letzten Build; Suchanfragen beziehen geänderte Dateien sofort direkt ein. Ein
git pullin einem Mirror oder eine soeben im Editor gespeicherte Zeile ist bei der nächsten Suche augenblicklich sichtbar. - Beim Öffnen eines Repositories prüft dowse automatisch, welche Dateien geändert, gelöscht oder verschoben wurden, während die App geschlossen war.
- Das Aktualisieren eines Index liest ausschließlich die veränderten Dateien ein und schreibt sie gestreamt in eine Kopie des Index. In einem Repository mit 245.000 Dateien und 1,7 GB Index benötigt ein solches Update rund 10 Sekunden – wo ein vollständiger Rebuild 9 Minuten dauern würde. Suchanfragen laufen währenddessen unterbrechungsfrei weiter.
Die Desktop-Oberfläche ist nativ und basiert auf GPUI, dem GPU-beschleunigten UI-Framework des Zed-Editors. Es gibt keinerlei Electron- oder Web-Overhead dazwischen.
Eine Kommandozeile für Entwickler und Coding-Agents
dowse search, dowse repos und die übrigen Unterbefehle steuern die laufende Desktop-App fern. Dadurch profitieren sie direkt von deren im Speicher gehaltenen Indizes und aktiven File-Watchern. Läuft die App noch nicht, startet der erste CLI-Befehl sie unbemerkt im Hintergrund ohne Fenster.
dowse search 'parse_config lang:rust' # Durchsucht alle dowse bekannten Reposdowse search --here 'parse_config' # Nur das aktuelle Repositorydowse search -t owner:my-org -l 'LegacyClient' # Nur Dateipfade, eingegrenzt auf eine Organisationdowse repos clone --from my-org --pull-every 1hDie CLI-Ausgabe wurde sowohl für Menschen als auch gezielt für Coding-Agents wie Claude Code, Codex oder Cursor optimiert. Wenn ein KI-Agent mit gewöhnlichem grep durch große Codebasen iteriert, verbringt er seine Zeit mit Dateizugriffen und vergeudet sein Kontextfenster an endlose Ausgaben. tgrep löst den ersten Teil innerhalb der GitHub Copilot CLI; dowse stellt jedem Agent denselben schnellen Index über alle lokalen Repositories hinweg bereit – inklusive durchdachtem Ausgabe-Budget:
-
Suchergebnisse landen auf stdout; Metadaten, Zähler und Ausführungszeiten auf stderr. Der Exit-Code ist 0 bei Treffern und 1, wenn nichts gefunden wurde.
-
Die Ausgabe ist standardmäßig auf 100 Trefferzeilen und maximal 20 Zeilen pro Datei limitiert, ergänzt durch eine Zusammenfassung im Footer. Wurden Ergebnisse abgeschnitten, schlägt der Footer konkrete Qualifikatoren vor, um die Treffer sinnvoll einzugrenzen:
narrow with: repo:api (120) language:Rust (80) path:src/** (64) -
--jsongibt Treffer und Zusammenfassung als strukturierte JSON-Objekte aus;--table csvexportiert die Tabellenansicht direkt als CSV. -
dowse guidegibt eine kurze Anleitung für Agenten aus. Trägt man diesen Leitfaden in die eigeneAGENTS.mdoderCLAUDE.mdein, kann der Agent auf sämtliche lokalen Repositories zugreifen, anstatt auf das Verzeichnis beschränkt zu bleiben, in dem er gestartet wurde.
dowse im Vergleich mit tgrep, Sourcegraph, Zoekt, GitHub code search und Entrian Source Search
| Kriterium | dowse | tgrep | GitHub code search | Sourcegraph | Zoekt | Entrian Source Search |
|---|---|---|---|---|---|---|
| Ausführung | Lokal auf dem Rechner | Lokal auf dem Rechner | Auf github.com | Eigener Server | Eigener Server | In Visual Studio |
| Suchbereich | Mehrere lokale Klone, jeder Branch, uncommittete Änderungen | Einzelner Verzeichnisbaum | GitHub-Repositories, nur Standard-Branch | Angebundene Code-Hosts | Eigens indizierte Repositories | Dateien der aktuellen Solution |
| Syntax | GitHub code search | Regex, grep-Stil | GitHub code search | Sourcegraph | Zoekt | Entrian |
| Index | Trigramm (tgrep), per Watcher aktuell | Trigramm | Proprietär von GitHub | Zoekt | Trigramm | Volltextindex |
| Interface | Desktop-App und CLI | CLI und lokaler Server | Web | Web | Web und API | IDE-Toolfenster |
| Kosten & Lizenz | Kostenlos, MIT | Kostenlos, MIT | In GitHub enthalten | Kommerziell | Kostenlos, Apache-2.0 | Lizenz pro Entwickler |
Fazit: Wer im Terminal blitzschnell in einem einzelnen Repository greppen will, greift zu tgrep. Wer im Unternehmen browserbasierte Codesuche für das gesamte Team benötigt, nutzt Sourcegraph oder betreibt Zoekt. Wenn der gesamte Code ohnehin auf GitHub liegt und der Default-Branch ausreicht, genügt GitHub code search. Wer jedoch auf dem eigenen Rechner über Dutzende Repositories und Branches hinweg suchen möchte – inklusive aller ungesicherten Änderungen, direkt aus der App oder über das Terminal des KI-Agenten und ohne Serverbetrieb –, für den ist dowse genau das Richtige.
dowse herunterladen
Auf der Releases-Seite stehen stets die aktuellsten vorkompilierten Binaries bereit, inklusive Prüfsummen in SHA256SUMS. Die Dateinamen folgen dem Schema dowse, gefolgt von Versionsnummer und Plattform:
| Plattform | Archiv |
|---|---|
| Windows (x64) | …-windows-x86_64.zip |
| macOS 11+ (Apple Silicon und Intel) | …-macos-universal.zip |
| Linux (x64) | …-linux-x86_64.tar.gz |
| Linux (arm64) | …-linux-aarch64.tar.gz |
Nach dem Entpacken fügt man einfach die Verzeichnisse mit den Repositories hinzu:
dowse ~/src ~/mirrorsEnthält ein Ordner mehrere Git-Repositories, werden alle automatisch erfasst. Unter Windows kann die Repositories-Seite zudem einen Eintrag „Add to dowse“ im Kontextmenü des Windows-Explorers hinterlegen.
Da die Binaries nicht mit einem kostenpflichtigen Entwicklerzertifikat signiert sind, melden Windows SmartScreen oder macOS Gatekeeper beim allerersten Start einen Hinweis; in der README wird beschrieben, wie man die Ausführung bestätigt. Wer aus dem Quellcode bauen möchte, führt mit aktuellem stabilem Rust einfach cargo run --release aus.
Häufig gestellte Fragen (FAQ)
Ist dowse eine Alternative zu Sourcegraph?
Für einen einzelnen Entwickler, der seine lokalen Repositories durchsuchen möchte: Ja. dowse deckt den Kernbereich von Sourcegraph ab – extrem schnelle Regex- und Volltextsuche über viele Repositories hinweg, ohne dass ein Server eingerichtet werden muss. Es ersetzt allerdings nicht Sourcegraphs semantische Code-Navigation (Code Intelligence), Batch Changes oder das kollaborative Web-Interface für Teams.
Ist dowse lediglich eine grafische Oberfläche für tgrep?
Teilweise. dowse nutzt tgreps Indexformat und liest wie schreibt in denselben .tgrep-Verzeichnissen, fungiert also auch als Desktop-Frontend für tgrep. Darüber hinaus bietet dowse jedoch die übergreifende Suche über mehrere Repositories in einer Abfrage, das Parsing der GitHub-Code-Search-Syntax, Tags, Facetten, Tabellenansichten, Datei-Vorschau sowie das automatische Klonen und Synchronisieren von GitHub-Repositories – lauter Dinge, die tgrep allein nicht abdeckt.
Worin unterscheidet sich dowse von Zoekt?
Beide setzen auf Trigramm-Indizes. Zoekt ist eine Suchmaschine, die als dauerhafter Dienst betrieben und von außen mit Indizes beliefert wird. dowse hingegen ist eine Anwendung, die Repositories auf der lokalen Festplatte selbstständig indiziert, diese per File-Watcher und inkrementellen Updates aktuell hält und eine moderne Desktop-Oberfläche sowie ein CLI bereitstellt.
Kann ich lokal mit der Syntax von GitHub code search suchen?
Ja. dowse unterstützt die wesentliche Syntax von GitHub code search: AND, OR, NOT, exakte Phrasen in Anführungszeichen, reguläre Ausdrücke in /regex/ sowie die Filter path:, language:, repo: und branch:, inklusive Negation mit vorangestelltem -.
Durchsucht dowse auch uncommittete Änderungen und andere Branches?
Ja. dowse greift direkt auf die Dateien auf der Festplatte zu. Es wird exakt der Stand durchsucht, der gerade ausgecheckt ist – einschließlich aller noch nicht committeten Änderungen. Da jedes Repository mit seinem aktuellen Branch getaggt ist, lässt sich die Suche mit branch:main gezielt auf den Hauptzweig einschränken.
Gibt es eine Alternative zu Entrian Source Search, die außerhalb von Visual Studio funktioniert?
dowse ist kein IDE-Add-in, sondern eine eigenständige Desktop-App und CLI, die Treffer auf Wunsch in gängigen Editoren wie VS Code, Cursor, Zed oder Sublime Text öffnet. Es durchsucht beliebig viele Repositories statt nur einer Solution und ist vollkommen kostenlos und quelloffen.
Werden bei der Nutzung von dowse Daten übertragen?
Nein. Die Indizes verbleiben lokal im jeweiligen .tgrep-Verzeichnis des Repositories, und alle Suchvorgänge laufen vollständig auf dem eigenen Rechner. Eine Netzwerkverbindung wird ausschließlich für explizit angestoßene Git- und GitHub-CLI-Aktionen genutzt (Auflisten von Organisations-Repositories, Klonen und Synchronisieren).
dowse ist auf GitHub verfügbar. Wenn es dir im Entwickleralltag Zeit spart, freuen wir uns über einen Stern; bei Fehlern oder Wünschen kannst du jederzeit ein Issue erstellen.